t-Test-Rechner
t-Test berechnen: Einstichproben-, gepaarter und Zweistichproben-Test (Welch oder gleiche Varianzen) aus Kennzahlen oder Rohdaten – mit p-Wert, kritischem t-Wert, Entscheidung und t-Tabelle.
t-Test-Rechner jetzt nutzenFachquelle zur Einordnung: Mathematische Fakultät LMU München
Statistik verstehst du hier als Auswahlhilfe für die passende Kennzahl, nicht als beliebige Sammlung von Zahlenwerten oder Beobachtungen.
t-Test berechnen: Einstichproben-, gepaarter und Zweistichproben-Test (Welch oder gleiche Varianzen) aus Kennzahlen oder Rohdaten – mit p-Wert, kritischem t-Wert, Entscheidung und t-Tabelle.
Zufallszahlen in einem frei wählbaren Bereich erzeugen – mit oder ohne Wiederholung und optional aufsteigend sortiert, etwa für Lottozahlen, Losentscheide und Stichproben.
Odds Ratio (Chancenverhältnis) aus der Vierfeldertafel berechnen: mit Konfidenzintervall nach Woolf, Haldane-Korrektur bei Nullzellen, relativem Risiko, Risikodifferenz und NNT.
Tschebyscheff-Ungleichung berechnen: Obergrenze für Abweichungen vom Erwartungswert, Mindestanteil im Intervall, k-Sigma-Form, ε-Form, Intervall und Binomialverteilung mit Vergleich zu Normalverteilung und exakter Wahrscheinlichkeit.
Konfidenzintervall berechnen für Mittelwert (t- oder z-Intervall, auch aus Rohdaten) und Anteil (Wilson und Wald) bei 80 bis 99,9 % Niveau – mit Rechenweg und benötigter Stichprobengröße.
Gini-Koeffizient berechnen aus einer Werteliste oder aus klassierten Daten: Gini, normierter Gini, Gini-Index, Anteil der obersten 10 und 20 Prozent und Lorenzkurven-Tabelle mit Rechenweg.
Lineare Regression berechnen aus x- und y-Werten: Regressionsgerade, Bestimmtheitsmaß R², Korrelation r, Standardfehler, Prognose und Residuentabelle, wahlweise auch exponentiell, logarithmisch, als Potenz oder quadratisch.
Relative Häufigkeit berechnen: aus einer Urliste oder aus h und n die Häufigkeitstabelle mit absoluter, relativer, prozentualer und kumulierter Häufigkeit, Modalwert und gekürztem Bruch, wahlweise mit Klassen.
Stichprobengröße berechnen für Umfragen (Anteil), Mittelwerte und den Vergleich zweier Gruppen (Poweranalyse) – mit Endlichkeitskorrektur, Rücklaufquote, Rechenweg und Tabelle nach Fehlermarge und Konfidenzniveau.
Freiheitsgrade (df) für t-Test, Welch-Test, χ²-Unabhängigkeits- und Anpassungstest, ANOVA, Regression und Varianz berechnen – mit Formel, kritischem Wert zum Signifikanzniveau α und Tabelle der kritischen t-Werte.
Kritischen Wert und p-Wert für z, t, χ² und F berechnen: ein- oder zweiseitig, mit Ablehnungsbereich, Testentscheidung und t-Wert-Tabelle.
Korrelation berechnen: Pearson r oder Spearman ρ aus Datenpaaren – mit r², t-Test, p-Wert, Konfidenzintervall nach Fisher, Stärke nach Cohen, Regressionsgerade und Rechentabelle je Paar.
Benfordsches Gesetz prüfen: Zahlenliste einfügen und die führenden Ziffern mit der Sollverteilung vergleichen – mit χ²-Test, MAD, Tabelle je Ziffer und Hinweisen zu Listengröße und Aussagekraft.
Arithmetisches Mittel, Summe, Anzahl, Minimum und Maximum einer Wertegruppe berechnen.
AQL-Stichprobenplan nach ISO 2859-1 berechnen: Losgröße und Prüfniveau eingeben, Kennbuchstabe, Stichprobenumfang, Annahmezahl und Rückweisezahl für Normal-, verschärfte und reduzierte Prüfung ermitteln.
Median und Modus einer Wertegruppe berechnen – inklusive Sortierung und Einordnung.
Varianz und Standardabweichung einer Datenmenge berechnen – Stichprobenvarianz und Grundgesamtheit.
Erwartungswert E(X), Varianz Var(X) und Standardabweichung σ einer diskreten Wahrscheinlichkeitsverteilung aus einer Wertetabelle berechnen.
Z-Score z = (x−μ)/σ und Percentilrang der Standardnormalverteilung berechnen.
Beliebiges Perzentil sowie Quartile Q1, Median und Q3, Interquartilsabstand, Minimum und Maximum aus einer Zahlenliste berechnen.
Mittelwert, Varianz und Standardabweichung für Population oder Stichprobe berechnen.
Einfache Wahrscheinlichkeiten berechnen, Gegenereignis, bedingte Wahrscheinlichkeit und Laplace-Experiment.
Permutationen, Kombinationen und Variationen mit und ohne Wiederholung berechnen, Binomialkoeffizient.
Spannweite R = Maximum − Minimum aus einer Zahlenliste berechnen – mit Median, Mittelwert, Minimum, Maximum und sortierter Werteliste.
Binomialverteilung berechnen: P(X=k), P(X<=k), P(X>=k) für Bernoulli-Ketten mit Erwartungswert, Varianz und Standardabweichung.
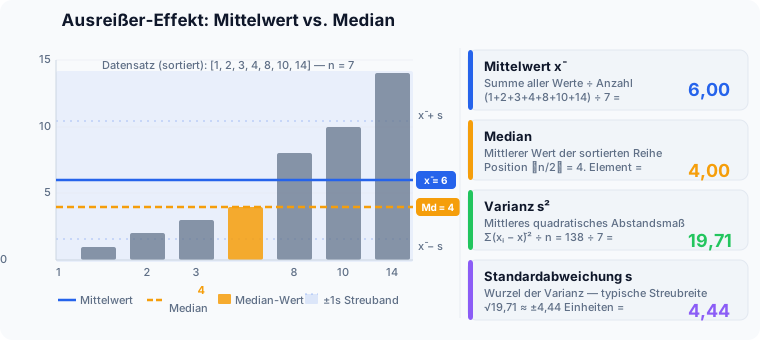
Nicht bloß eine Liste von Kennzahlen bekommst du hier, sondern den Hub für die Auswahl des passenden Auswertungswegs: typische Lage, mittlere Position, Anzahl möglicher Fälle und später auch Streuung oder Wahrscheinlichkeit. Diese Auswahl entscheidet, ob ein Durchschnitt, ein Median oder ein kombinatorischer Zählpfad zu deiner Frage passt. Von allgemeinen Mess- oder Beobachtungsseiten hebt sich der Hub gerade dadurch ab, dass er Datensätze methodisch ordnet, statt nur Werte aufzuzählen.
Nach der Natur der Frage differenziert dieser Hub. Liegt eine Datenreihe vor und soll die typische Mitte bestimmt werden, führt der Pfad zum Durchschnitt — anfällig für Ausreißer. Ist Robustheit gefragt, wählt der Median die sortierte Mitte unabhängig von Extremwerten. Geht es um die Anzahl möglicher Anordnungen oder Auswahlen, löst Kombinatorik über Fakultät und Binomialkoeffizient. Diese drei Antworten auf drei verschiedene Fragen sind der Kern, der diese Unterkategorie von einer allgemeinen Rechensammlung unterscheidet.
Bereite die Daten vor dem ersten Lauf vollständig auf: gleiche Einheit, gleiche Bedeutung und eine klare Trennung zwischen Messwerten, Häufigkeiten und Auswahlparametern. Für Durchschnitt und Median braucht der Rechner die eigentlichen Zahlenwerte, für Kombinatorik dagegen die Größen n, k sowie die Frage, ob Reihenfolge und Wiederholung zählen. Ohne diese Vorentscheidung lässt sich eine Statistikaufgabe zwar starten, aber kaum sinnvoll deuten.
Der Durchschnitt addiert die Werte und teilt durch ihre Anzahl, der Median greift zur sortierten Mitte, und die Kombinatorik zählt Möglichkeiten über Fakultäten, Kombinationen oder Permutationen. Diese Formeln beantworten bewusst unterschiedliche Fragen: typische Lage, robuste Mitte oder Anzahl möglicher Fälle. Eben deshalb führt die Hubseite nicht zu einer Einheitskennzahl, sondern zu klar getrennten Statistikpfaden.
Immer wieder kippen Auswertungen, wenn nicht vergleichbare Datenreihen miteinander gemischt, klare Ausreißer ignoriert oder Kombinatorik mit Wahrscheinlichkeit verwechselt werden. Ebenso häufig wird der Durchschnitt als einzig richtige Mitte gelesen, obwohl bei schiefen Verteilungen der Median die realistischere Aussage über die Daten liefert.
Sortier Datenreihen immer einmal von klein nach groß und halt offensichtliche Ausreißer separat fest. Schon dieser eine Schritt zeigt dir oft, ob ein Mittelwert ausreicht oder der Median robuster wäre. Bei Zählproblemen bringt zusätzlich die Frage weiter, ob Reihenfolge und Wiederholung wirklich eine Rolle spielen.
Belastbare Aussagen liefert dir die Statistik nur dann, wenn Datentyp, Ausreißer und Fragestellung zur Kennzahl passen. Sortier zuerst den Datensatz oder umreiß das Auswahlproblem und wähl danach Mittelwert, Median oder Kombinatorik ganz gezielt aus.
Diese Unterkategorie nutzt eine differenzierte Auslegung je Themencluster, damit Ergebnisse nicht nur korrekt berechnet, sondern auch im passenden Entscheidungskontext verstanden werden.
t-Test berechnen: Einstichproben-, gepaarter und Zweistichproben-Test (Welch oder gleiche Varianzen) aus Kennzahlen oder Rohdaten – mit p-Wert, kritischem t-Wert, Entscheidung und t-Tabelle.
t-Test-Rechner jetzt nutzenZufallszahlen in einem frei wählbaren Bereich erzeugen – mit oder ohne Wiederholung und optional aufsteigend sortiert, etwa für Lottozahlen, Losentscheide und Stichproben.
Zufallszahlen-Generator jetzt nutzenOdds Ratio (Chancenverhältnis) aus der Vierfeldertafel berechnen: mit Konfidenzintervall nach Woolf, Haldane-Korrektur bei Nullzellen, relativem Risiko, Risikodifferenz und NNT.
Odds-Ratio-Rechner jetzt nutzenTschebyscheff-Ungleichung berechnen: Obergrenze für Abweichungen vom Erwartungswert, Mindestanteil im Intervall, k-Sigma-Form, ε-Form, Intervall und Binomialverteilung mit Vergleich zu Normalverteilung und exakter Wahrscheinlichkeit.
Tschebyscheff-Rechner jetzt nutzenWeiterführende Unterkategorien und Themen
Alle verwandten Unterkategorien auf einen Blick, damit du direkt zum passenden Themenbereich wechseln kannst.
Quellen, Transparenz und Haftung
Haftungsausschluss
Die Ergebnisse dieses Rechners sind Orientierungswerte und ersetzen keine professionelle Beratung. Für verbindliche Entscheidungen – insbesondere in finanziellen, gesundheitlichen oder rechtlichen Angelegenheiten – empfehlen wir die Einholung fachkundiger Beratung. Aktuelle Vertrags-, Produkt- und Regulierungsdaten können von den Rechenwerten abweichen.
Die Unterkategorie Statistik in Mathematik folgt denselben Qualitäts- und Transparenzregeln wie alle relevanten Rechnerseiten. Im Halbjahresrhythmus nehmen wir uns die Statistik-Unterkategorie mit den deskriptiv-statistischen Standardverfahren der Sekundarstufe I und II vor: Stimmen die Formeln für Mittelwert, Median und Kombinatorik, und ist die Grenze zwischen Lagekennzahlen und Zählproblemen sachgerecht gezogen?
Quelle: Deskriptive Statistik: Mittelwert, Median und Kombinatorik nach schulüblichen Verfahren der Sekundarstufe I und II, Schulübliche Kombinatorik (Fakultät, Binomialkoeffizient, Permutation) — Standardlehrwerke DE Klassen 9–12 (Stand Mai 2026)
Stand: 2026-11-08
math.lmu.de
uni-bonn.de
mathematik.de
Dokumentierte Quellen im Domain-Rahmen: 2