Zum Hauptinhalt springen

Relative Häufigkeit berechnen: Urliste, Tabelle und Prozent

MathematikStand Noch keine Bewertung
Was liegt vor?
Nachkommastellen der relativen Häufigkeit
Anzeige

Kurzantwort

Die relative Häufigkeit ist die absolute Häufigkeit geteilt durch die Zahl aller Beobachtungen, f = h / n. Der Rechner macht aus einer Urliste die komplette Tabelle mit absoluter, relativer, prozentualer und kumulierter Häufigkeit.

Relative Häufigkeit berechnen: Urliste oder h und n eingeben, Tabelle mit absolut, relativ

Kilian AchatzFachredaktion Mathematik
Geprüft: Review-Team Rechner-Portal (Okt. 2026)Stand:

Rechenbasis

Annahmen und Grenzen

Was der Rechner voraussetzt und wo seine Aussage endet.

4 Annahmen und 3 Grenzen

Annahmen

  • Jeder Eintrag der Urliste ist genau eine Beobachtung; gleiche Zahlen (3 und 3,0) und gleicher Text ohne Beachtung der Groß- und Kleinschreibung zählen als dieselbe Ausprägung. Höchstens 10.000 Einträge und 200 Tabellenzeilen.
  • Zahlen werden aufsteigend sortiert, Kategorien in der Reihenfolge des ersten Auftretens gelistet; die kumulierten Werte H und F sind nur bei geordneten Merkmalen aussagekräftig.
  • Klassen sind links geschlossen und rechts offen [von; bis); die erste Klasse beginnt beim größten Vielfachen der Klassenbreite, das den kleinsten Wert nicht übersteigt; leere Klassen bleiben als Zeile mit h = 0 stehen.
  • Die relative Häufigkeit gilt für die vorliegende Stichprobe; als Wahrscheinlichkeit darf sie nur bei großem Stichprobenumfang und gleichbleibenden Bedingungen gelesen werden.

Grenzen

  • Der Rechner prüft nicht, ob die Stichprobe repräsentativ oder die Erhebung sauber war; Tippfehler in Kategorien („Blau“ und „Blua“) zählt er als zwei Ausprägungen.
  • Durch das Runden kann die Summe der angezeigten relativen Häufigkeiten von 1 abweichen; der Rechner weist die Rundungsdifferenz aus, rechnet aber intern ungerundet.
  • Bei klassierten Daten gehen die Einzelwerte verloren; die Häufigkeitsdichte unterstellt Gleichverteilung innerhalb der Klasse, und die Wahl der Klassenbreite beeinflusst das Bild.

Stand der Prüfung: Formeln zeitlos (Definitionen der deskriptiven Statistik); Quellen abgerufen am 09.10.2026.
Überblick

Relative und absolute Häufigkeit berechnen: Urliste, Häufigkeitstabelle und Prozent

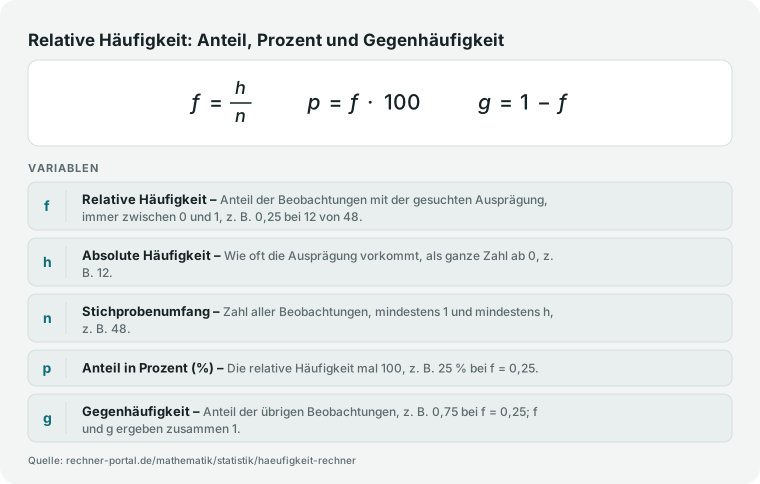
Die relative Häufigkeit f gibt an, welchen Anteil eine Ausprägung an allen Beobachtungen hat: Sie ist die absolute Häufigkeit h geteilt durch den Stichprobenumfang n, also f = h / n. Dieser Rechner macht aus einer Urliste, der ungeordneten Liste aller Beobachtungen, die komplette Häufigkeitstabelle mit absoluter, relativer, prozentualer und kumulierter Häufigkeit.

Für die Urliste 2; 3; 3; 5; 5; 5 mit n = 6 ergibt sich h(5) = 3 und f(5) = 3 / 6 = 0,5; die kumulierte relative Häufigkeit F(3) = 0,5 sagt, dass die Hälfte der Werte höchstens 3 beträgt.

Wer nur h und n kennt, rechnet im Einzelwert-Modus: 12 von 48 sind f = 0,25 = 25 % = 1/4. Wer viele verschiedene Zahlen hat, teilt sie in Klassen ein und erhält die Häufigkeitsdichte. Typische Fragen sind: Wie viel Prozent der Klasse hat eine Drei?

Welcher Wert kommt am häufigsten vor? Wie viele Antworten lagen höchstens bei 3? Die Summe aller absoluten Häufigkeiten ist immer n, die Summe aller relativen Häufigkeiten immer 1.

Die relative Häufigkeit beschreibt die vorliegende Stichprobe; als Wahrscheinlichkeit taugt sie erst als Schätzwert bei großem n und gleichbleibenden Bedingungen.

Eingaben

Urliste, h und n oder Klassenbreite: Was trägst du ein?

Im Feld „Was liegt vor?“ wählst du die Art der Daten. Bei „Urliste“ trägst du jede Beobachtung einzeln ein, getrennt durch Leerzeichen, Semikolon oder Zeilenumbruch, etwa Würfelergebnisse wie 1 1 2 2 2 3 oder Antworten wie rot, blau, rot.

Zahlen dürfen ein Dezimalkomma haben. Text zählt der Rechner ohne Beachtung der Groß- und Kleinschreibung, „Blau“ und „blau“ sind also dieselbe Ausprägung; Namen mit Leerzeichen trennst du mit Semikolon. Erlaubt sind bis zu 10.000 Einträge.

Im Einzelwert-Modus brauchst du die absolute Häufigkeit h und den Stichprobenumfang n als ganze Zahlen, wobei h nicht größer als n sein darf.

Bei „Klassen“ kommt die Klassenbreite dazu: Bei 10 gehört eine Körpergröße von 179,9 cm zur Klasse „170 bis unter 180“, genau 180 cm schon zur nächsten. Die Nachkommastellen steuern nur die Anzeige, gerechnet wird ungerundet.

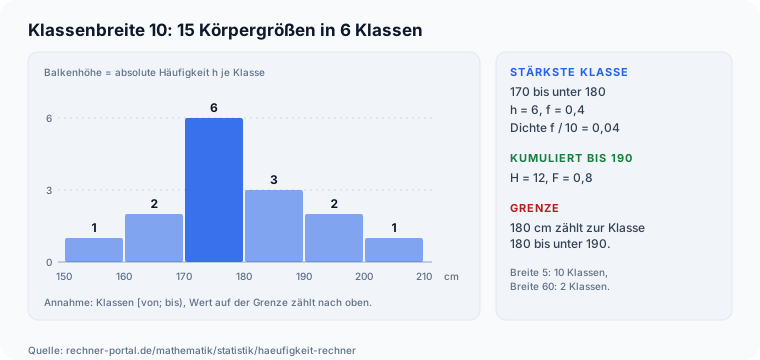
Zahlen mit Tausenderpunkt wie 1.500 weist der Rechner ab, weil der Punkt mehrdeutig wäre; ein Tippfehler wie „Blua“ zählt als eigene Ausprägung. Klassenbildung: 15 Körpergrößen von 158 bis 201 cm mit Klassenbreite 10 ergeben die Klassen 150 bis 210 mit h 1, 2, 6, 3, 2 und 1

Praxisfälle

Relative Häufigkeit berechnen nach Situation

Neun typische Suchfragen zur relativen Häufigkeit, jede mit Eingaben und dem nachgerechneten Ergebnis aus dem Rechner oben.

  1. Relative Häufigkeit aus der Urliste 2; 3; 3; 5; 5; 5

    „Wie groß sind absolute und relative Häufigkeit der 5 in der Urliste 2; 3; 3; 5; 5; 5?“

    Eingabe
    Urliste: 2;3;3;5;5;5 | 3 Nachkommastellen
    Ergebnis
    n = 6 | h(2) = 1, h(3) = 2, h(5) = 3 | f(5) = 0,5 | F(3) = 0,5
  2. Relative Häufigkeit bei 12 von 48

    „Wie groß ist die relative Häufigkeit, wenn 12 von 48 Befragten mit dem Rad fahren?“

    Eingabe
    Einzelwert | h = 12 | n = 48
    Ergebnis
    f = 0,25 | 25 % | Bruch 1/4 | Gegenhäufigkeit 0,75
  3. Relative Häufigkeit bei 30 von 200

    „Wie viel Prozent sind 30 von 200, und wie lautet der gekürzte Bruch?“

    Eingabe
    Einzelwert | h = 30 | n = 200
    Ergebnis
    f = 0,15 | 15 % | Bruch 3/20
  4. Notenspiegel mit 24 Arbeiten

    „Wie verteilen sich 24 Noten, und wie groß ist der Anteil mindestens ausreichender Arbeiten?“

    Eingabe
    Urliste: 1 1 2 2 2 2 2 3 3 3 3 3 3 3 3 4 4 4 4 4 5 5 5 6
    Ergebnis
    h = 2, 5, 8, 5, 3, 1 | Modalwert 3 (f = 0,333) | F(4) = 0,833 | Σ f gerundet 0,999
  5. Kategorien zählen: rot, blau, grün

    „Wie oft kommen die Farben in rot, blau, rot, grün, blau, rot vor?“

    Eingabe
    Urliste: rot, blau, rot, grün, blau, rot
    Ergebnis
    rot h = 3, f = 0,5 | blau h = 2, f = 0,333 | grün h = 1, f = 0,167
  6. Körpergrößen in Klassen einteilen

    „Wie verteilen sich 15 Körpergrößen von 158 bis 201 cm auf Klassen der Breite 10?“

    Eingabe
    Klassen | Klassenbreite 10 | Urliste: 158 162 165 170 171 172 175 175 178 180 181 185 190 193 201
    Ergebnis
    h = 1, 2, 6, 3, 2, 1 | stärkste Klasse 170 bis unter 180 (f = 0,4, Dichte 0,04)
  7. Modalwert bei zwei häufigsten Werten

    „Welcher Wert ist der Modalwert, wenn zwei Werte gleich oft vorkommen?“

    Eingabe
    Urliste: 1 1 2 2 3 | 3 Nachkommastellen
    Ergebnis
    Modalwerte 1 und 2 mit je h = 2 (f = 0,4) | h(3) = 1 | F(2) = 0,8
  8. Relative Häufigkeit und Wahrscheinlichkeit beim Würfeln

    „Wie oft fiel die Sechs in 20 Würfen, und wie weit liegt das von 1/6 entfernt?“

    Eingabe
    Urliste: 1 1 2 2 2 3 3 3 3 4 4 4 5 5 5 6 6 6 6 6
    Ergebnis
    h(6) = 5 | f = 0,25 (Modalwert) | theoretisch 1/6 = 0,167 | F(3) = 0,45
  9. Klassenbreite 5 statt 10

    „Wie ändert sich die Verteilung der 15 Körpergrößen bei schmaleren Klassen?“

    Eingabe
    Klassen | Klassenbreite 5 | Urliste: 158 162 165 170 171 172 175 175 178 180 181 185 190 193 201
    Ergebnis
    10 Klassen | zwei stärkste Klassen (170 bis unter 175 und 175 bis unter 180) mit h = 3 und f = 0,2 | Dichte 0,04 | Σ f gerundet 1,001

Berechnung

Relative Häufigkeit berechnen: Formeln für f, H und F

Zuerst zählt der Rechner, wie oft jede Ausprägung a_j vorkommt. Das ist die absolute Häufigkeit h(a_j), alle h zusammen ergeben n.

Die relative Häufigkeit ist f(a_j) = h(a_j) / n, die Prozentangabe f · 100. Kumuliert wird von oben nach unten: H(a_j) = h(a_1) + … + h(a_j) und F(a_j) = H(a_j) / n.

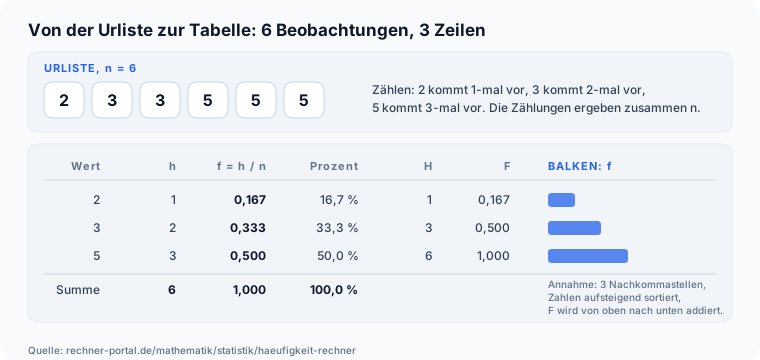
Zahlen sortiert der Rechner aufsteigend, Kategorien stehen in der Reihenfolge des ersten Auftretens. Urliste 2; 3; 3; 5; 5; 5 wird zur Tabelle: h gleich 1, 2 und 3, f gleich 0,167, 0,333 und 0,5, F gleich 0,167, 0,5 und 1 In der Beispielliste gilt h(2) = 1, h(3) = 2 und h(5) = 3, also f = 1/6 = 0,167, 2/6 = 0,333 und 3/6 = 0,5 mit F(2) = 0,167, F(3) = 0,5 und F(5) = 1.

Gerundet wird erst zum Schluss, der Rechner arbeitet mit ungerundeten Brüchen. Deshalb kann die Summe der angezeigten Werte von 1 abweichen, bei drei gleichen Dritteln etwa 0,999; Summenzeile und Kontrolle weisen diese Rundungsdifferenz aus.

Bei Klassen kommt die Häufigkeitsdichte f / Breite hinzu, die Höhe der Säule im Histogramm. Im Einzelwert-Modus entfällt die Zählung: Aus h = 12 und n = 48 folgt f = 12 / 48 = 0,25, also 25 %.

Den Bruch kürzt der Rechner mit dem größten gemeinsamen Teiler, hier 12, zu 1/4. Die Gegenhäufigkeit 1 − f = 0,75 gehört zu den übrigen 36 Beobachtungen.

Bei Klassen ordnet er jeden Wert x der Klasse mit der laufenden Nummer ⌊(x − Anfang) / Breite⌋ zu; ein Wert genau auf der Grenze gehört zur oberen Klasse, leere Klassen bleiben mit h = 0 stehen.

Relative Häufigkeit: f gleich h durch n, Prozent gleich f mal 100, Gegenhäufigkeit g gleich 1 minus f.
Formeln des Häufigkeit-Rechners: Die relative Häufigkeit ist die absolute Häufigkeit geteilt durch den Stichprobenumfang, der Prozentwert das Hundertfache davon, die Gegenhäufigkeit der Rest bis 1.

Nachschlagen

Relative Häufigkeit, Prozent und Bruch typischer Fälle

Wie groß ist der Anteil, wenn h von n Beobachtungen zutreffen? Zehn häufige Paare zeigen die relative Häufigkeit f = h / n mit drei Nachkommastellen, den Prozentwert und den gekürzten Bruch. Besonders das Paar 12 von 48 und das Paar 30 von 200 zeigen, dass die größere absolute Zahl nicht den größeren Anteil liefern muss.

Relative Häufigkeit f, Prozentwert und gekürzter Bruch für zehn Paare aus absoluter Häufigkeit h und Stichprobenumfang n
Absolute Häufigkeit hStichprobenumfang nRelative Häufigkeit fProzentGekürzter Bruch
120,50050,0 %1/2
130,33333,3 %1/3
140,25025,0 %1/4
150,20020,0 %1/5
160,16716,7 %1/6
380,37537,5 %3/8
5200,25025,0 %1/4
12480,25025,0 %1/4
302000,15015,0 %3/20
45600,75075,0 %3/4

Berechnet mit der Rechenfunktion des Rechners im Modus Einzelwert. Der Bruch ist mit dem größten gemeinsamen Teiler gekürzt; die Paare sind Rasterwerte, keine Erhebungsdaten.

Rundungsdifferenz bei gleich häufigen Ausprägungen

Wann ergibt die Summe der gerundeten relativen Häufigkeiten nicht genau 1? Wenn k verschiedene Werte je einmal vorkommen, ist jede relative Häufigkeit 1 / k. Die Tabelle zeigt für k von 2 bis 12 den auf drei Stellen gerundeten Einzelwert, die Summe der gerundeten Zeilen und die Abweichung von 1.

Summe der auf drei Nachkommastellen gerundeten relativen Häufigkeiten bei k gleich häufigen Werten und Abweichung von 1
Anzahl gleich häufiger Werte kf je Wert (gerundet)Summe der gerundeten fDifferenz zu 1
20,5001,0000,000
30,3330,999−0,001
40,2501,0000,000
50,2001,0000,000
60,1671,0020,002
70,1431,0010,001
80,1251,0000,000
90,1110,999−0,001
100,1001,0000,000
110,0911,0010,001
120,0830,996−0,004

Berechnet mit der Rechenfunktion des Rechners im Modus Urliste (Werte 1 bis k, je einmal). Die ungerundeten Brüche ergeben immer genau 1; die Differenz entsteht nur durch das Runden der einzelnen Zeilen.

Expertenmodus

Häufige Fragen zur relativen Häufigkeit

Wie berechnet man die relative Häufigkeit?

Teile die absolute Häufigkeit h durch den Stichprobenumfang n: f = h / n. Bei 12 von 48 Befragten ergibt sich f = 12 / 48 = 0,25, das sind 25 % oder der gekürzte Bruch 1/4; die Gegenhäufigkeit beträgt 0,75.

Bei 30 von 200 Rückmeldungen sind es f = 0,15 oder 15 %, also 3/20. Im Rechner wählst du dafür den Modus Einzelwert, trägst h und n ein und liest Dezimalzahl, Prozentwert und Bruch ab.

Liegt eine Urliste vor, zählt der Rechner h für jeden Wert selbst und liefert die ganze Tabelle. Die relative Häufigkeit liegt immer zwischen 0 und 1, und die Summe aller relativen Häufigkeiten einer Verteilung ergibt 1.

Liegt dein Ergebnis darüber, ist h größer als n eingetragen worden oder die Zählung enthält Doppelungen. Achte darauf, dass n wirklich alle Beobachtungen umfasst, auch die ohne das gesuchte Merkmal, sonst wird der Anteil zu groß.

Was ist der Unterschied zwischen absoluter und relativer Häufigkeit?

Die absolute Häufigkeit h zählt, wie oft ein Wert vorkam, die relative Häufigkeit f = h / n setzt diese Zahl ins Verhältnis zur Gesamtzahl.

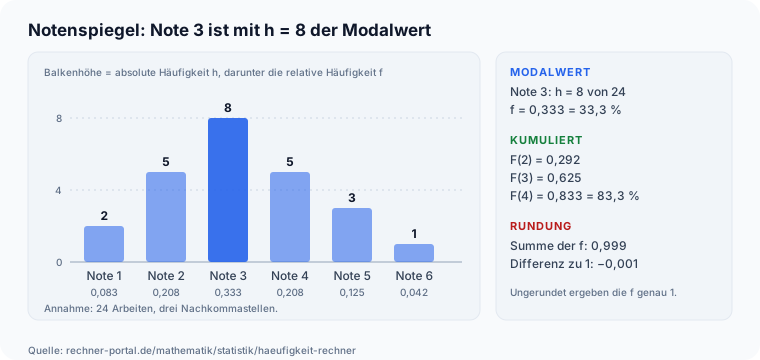
Im Notenspiegel mit 24 Arbeiten hat die Note 3 die absolute Häufigkeit 8 und die relative Häufigkeit 8 / 24 = 0,333, also 33,3 %. Die absolute Häufigkeit passt, wenn du nur eine Gruppe betrachtest.

Sobald du verschieden große Gruppen vergleichst, brauchst du die relative: 8 von 24 sind 33,3 %, 30 von 200 sind 15 %, obwohl 30 die größere Zahl ist. Die absoluten Zahlen summieren sich zu n (hier 24), die relativen zu 1 oder 100 %.

Fachlich verwandt ist die kumulierte Häufigkeit, die alle Werte bis zu einer Stufe zusammenfasst.

Der Rechner zeigt alle drei Größen nebeneinander in einer Tabelle, sodass du ohne weitere Rechnung zwischen Anzahl, Anteil und Prozent wechseln kannst, und rundet die relative Häufigkeit auf zwei, drei oder vier Stellen, wie du es einstellst.

Wie erstelle ich eine Häufigkeitstabelle aus einer Urliste?

Die Urliste ist die ungeordnete Liste aller Beobachtungen. Trage sie in den Rechner ein, getrennt durch Leerzeichen, Semikolon oder Zeilenumbruch, und er sortiert, zählt und rechnet die Spalten aus.

Für die Liste 2 3 3 5 5 5 entstehen drei Zeilen: Wert 2 mit h = 1 und f = 0,167, Wert 3 mit h = 2 und f = 0,333, Wert 5 mit h = 3 und f = 0,5, dazu die kumulierte Spalte bis 1,0.

Von Hand ersetzt die Strichliste den ersten Schritt: je Beobachtung ein Strich, jeder fünfte Strich quert die vier davor, am Ende zählst du je Zeile zusammen. Die Summe der h muss n ergeben, sonst hast du einen Wert vergessen oder doppelt gezählt.

Kategorien wie rot, blau und grün funktionieren genauso und werden in der Reihenfolge ihres ersten Auftretens gelistet.

In Excel zählt ZÄHLENWENN je Wert; der Rechner erspart dir dabei die Hilfsspalten und rechnet relative und kumulierte Werte sofort mit aus, ohne dass du Formeln pflegen musst.

Was ist der Modalwert und wie finde ich ihn?

Der Modalwert ist der Wert mit der größten absoluten Häufigkeit, also der häufigste Wert einer Liste. Im Notenspiegel mit 24 Arbeiten ist es die Note 3 mit h = 8 und f = 0,333. Bei 20 Würfelwürfen ist es die Sechs mit h = 5 und f = 0,25.

Der Rechner nennt den häufigsten Wert direkt über der Tabelle. Gibt es mehrere Werte mit der gleichen Höchstzahl, nennt er alle: In der Liste 1 1 2 2 3 sind 1 und 2 Modalwerte mit je h = 2 und f = 0,4, die Verteilung ist zweigipflig.

Anders als der Mittelwert funktioniert der Modalwert auch bei Kategorien, etwa bei Farben oder Antworten wie ja und nein.

Bei Messwerten mit vielen verschiedenen Zahlen taugt er erst nach dem Einteilen in Klassen: Dann ist die stärkste Klasse gemeint, bei den 15 Körpergrößen die Klasse 170 bis unter 180 mit h = 6.

Ergänze ihn bei Bedarf durch Median und Mittelwert, sie liegen in schiefen Verteilungen auseinander.

Was bedeutet kumulierte Häufigkeit, und was ist die empirische Verteilungsfunktion?

Die kumulierte absolute Häufigkeit H(a) addiert die h aller Werte bis einschließlich a, die kumulierte relative Häufigkeit F(a) = H(a) / n gibt den Anteil der Beobachtungen an, die höchstens so groß sind.

Als Funktion von a aufgetragen ist F die empirische Verteilungsfunktion, eine Treppe, die von 0 auf 1 steigt. Für die Urliste 2 3 3 5 5 5 gilt H(3) = 1 + 2 = 3 und F(3) = 3 / 6 = 0,5: Die Hälfte der Werte ist höchstens 3.

Im Notenspiegel mit 24 Arbeiten ist F(4) = 20 / 24 = 0,833, also haben 83,3 % die Note 4 oder eine bessere, kleinere Note. Bei der letzten Zeile steht immer F = 1.

Die kumulierte Spalte hat nur bei geordneten Werten, etwa Noten, Größen oder Alter, eine Bedeutung. Bei Kategorien wie Farben hängt sie von der zufälligen Reihenfolge ab und sagt nichts aus.

Ist die relative Häufigkeit immer in Prozent, und wie rechne ich zurück?

Nein, die relative Häufigkeit ist zuerst eine Zahl zwischen 0 und 1 und lässt sich als Dezimalzahl, Bruch oder Prozent schreiben. f = 0,25 ist gleich 1/4 und gleich 25 %. Der Rechner zeigt alle drei Darstellungen: 12 von 48 sind 0,25, 25 % und 1/4.

Für den Wechsel zu Prozent multiplizierst du mit 100, für den Rückweg teilst du durch 100. Um von der relativen auf die absolute Häufigkeit zu kommen, multiplizierst du mit dem Stichprobenumfang: h = f · n.

Mit f = 0,15 und n = 200 ergibt sich h = 30, mit f = 0,25 und n = 48 ergibt sich h = 12. Das funktioniert nur, wenn n bekannt ist; aus Prozentwerten allein lässt sich die Anzahl nicht bestimmen.

Prozentwerte, die gerundet angegeben sind, liefern beim Zurückrechnen nur eine Näherung, die ungefähr ganzzahlig ausfallen muss. Wenn nicht, passen n und f nicht zusammen, oder die Quelle hat gerundet.

Ist die relative Häufigkeit dasselbe wie die Wahrscheinlichkeit?

Nein, aber sie hängen zusammen. Die relative Häufigkeit beschreibt, was in deiner Stichprobe tatsächlich passiert ist, die Wahrscheinlichkeit, was bei einem Zufallsvorgang theoretisch zu erwarten ist.

Bei einem fairen Würfel beträgt sie für die Sechs 1/6 = 0,167. In einer Liste mit 20 Würfen, die fünf Sechsen enthält, ist die relative Häufigkeit dagegen 0,25.

Das Gesetz der großen Zahlen besagt, dass sich die relative Häufigkeit mit wachsender Zahl der Versuche der Wahrscheinlichkeit annähert. Die typische Abweichung √(p · (1 − p) / n) beträgt bei 20 Würfen etwa 0,083 und bei 6.000 Würfen nur noch 0,0048.

Kleine Stichproben schwanken also stark, große kaum. Die Wahrscheinlichkeit für zwei Sechsen hintereinander ist 1/36, das ist eine Rechnung und keine Zählung.

Aus einer Urliste liest du nur die relative Häufigkeit ab, mit Würfelaufgaben oder Zufallsexperimenten rechnest du dagegen Wahrscheinlichkeiten theoretisch.

Wie berechne ich den Notenspiegel und die Notenverteilung?

Trage alle Noten als Urliste ein und lass die Tabelle erstellen. Für 24 Arbeiten mit den Noten 1 1 2 2 2 2 2 3 3 3 3 3 3 3 3 4 4 4 4 4 5 5 5 6 ergibt der Rechner h = 2, 5, 8, 5, 3 und 1 für die Noten 1 bis 6.

Der Anteil je Note ist 8,3 %, 20,8 %, 33,3 %, 20,8 %, 12,5 % und 4,2 %; die Note 3 ist mit 8 Arbeiten der Modalwert. Die kumulierte Spalte zeigt, dass F(2) = 0,292 der Arbeiten mit 1 oder 2 bewertet wurden und F(4) = 0,833 mit 4 oder besser.

Den Notenschnitt liefert die Häufigkeitstabelle nicht direkt, dafür brauchst du den Durchschnitt, den du mit h gewichtest. Der Notenspiegel selbst ist nur die absolute Verteilung.

Prozentwerte machen Klassen mit verschiedener Schülerzahl vergleichbar. Da jede Zeile gerundet wird, ergibt die Summe der Prozente manchmal 99,9 statt 100; das ist reine Rundung und kein Rechenfehler.

Wie breit sollen die Klassen im Histogramm sein, und was ist die Häufigkeitsdichte?

Eine feste Regel gibt es nicht; das Ziel ist ein Bild, das die Verteilung zeigt. Zu schmale Klassen zerlegen die Daten wieder in Einzelwerte, zu breite verstecken sie.

Bei 15 Körpergrößen von 158 bis 201 cm liefert die Breite 10 sechs Klassen, die stärkste ist 170 bis unter 180 mit h = 6 und f = 0,4. Die Breite 5 ergibt zehn Klassen mit h von 0 bis 3, darunter eine leere.

Die Klassen sind rechts offen: Ein Wert genau auf der Grenze, hier 180 cm, zählt zur oberen Klasse. Die Häufigkeitsdichte ist f geteilt durch die Klassenbreite, hier 0,4 / 10 = 0,04 je cm.

Sie macht Klassen unterschiedlicher Breite vergleichbar, denn in einem Histogramm steht die Fläche, nicht die Höhe, für den Anteil. Bei gleicher Breite zeigt die Höhe der Säule direkt h oder f.

Probiere im Rechner zwei, drei Breiten aus und wähle die, bei der die Form stabil bleibt.

Wie groß ist der Stichprobenumfang n, und warum ergibt die Summe 0,999?

Der Stichprobenumfang n ist die Zahl aller Beobachtungen, also die Summe aller absoluten Häufigkeiten. Im Notenspiegel ist n = 24, bei den Würfen n = 20, bei den Körpergrößen n = 15.

Der Rechner zeigt n über der Tabelle und prüft in der Kontrollzeile, dass die Summe der h genau n ergibt.

Die Summe der relativen Häufigkeiten kann dagegen leicht von 1 abweichen, weil jede Zeile einzeln gerundet wird: Beim Notenspiegel mit drei Nachkommastellen ergibt sich 0,999 statt 1, die Rundungsdifferenz beträgt −0,001.

Die ungerundeten Brüche ergeben exakt 1. Bei den Körpergrößen in Fünferklassen sind es 1,001. Das ist kein Rechenfehler; wer genauer rechnen will, stellt vier Nachkommastellen ein oder rechnet mit den Brüchen.

Wichtig bleibt, dass n von der Fragestellung abhängt: Wer den Anteil unter allen Befragten sucht, nimmt alle Befragten als n, wer nur die Gültigen betrachtet, die Zahl der gültigen Antworten. Nenne die Wahl bei jeder Angabe.

Hinweise

Häufigkeitstabelle lesen: Modalwert, kumuliert und Rundung

Lies zuerst den häufigsten Wert, den Modalwert: In 2; 3; 3; 5; 5; 5 ist es die 5 mit f = 0,5, also die Hälfte aller Beobachtungen. Eine Ausprägung mit f = 0,167 ist ein Sechstel.

Die Prozentspalte rechnet dasselbe um, 50 %, 33,3 % und 16,7 %. Die kumulierte Spalte beantwortet „höchstens“-Fragen: F(3) = 0,5 heißt, dass 50 % der Werte höchstens 3 sind.

Im Notenspiegel von 24 Arbeiten haben F(4) = 20 / 24 = 0,833 der Arbeiten mindestens die Note 4. Prüfe danach die Summenkontrolle.

Zeigt sie eine Rundungsdifferenz, etwa 0,999 beim Notenspiegel, ist nichts falsch: Wähle mehr Nachkommastellen oder nenne bei der Weitergabe die Rundung. Beachte auch den Umfang.

Bei n = 6 verschiebt eine zusätzliche Beobachtung f um bis zu 14,3 Prozentpunkte, bei n = 600 nur um 0,17. Je kleiner n ist, desto weniger sagt die Zahl über andere Stichproben.

Vergleiche Gruppen immer mit f, nie mit h: 12 von 48 sind f = 0,25, 30 von 200 nur f = 0,15 oder 3/20, obwohl die zweite Gruppe die größere absolute Zahl hat. Den gekürzten Bruch 1/4 statt 12/48 merkst du dir leichter.

Teilen sich zwei Werte den Spitzenplatz, nennt der Rechner beide als Modalwerte; kommen alle gleich oft vor, gibt es keinen eindeutigen. Kommt jeder Zahlenwert nur einmal vor, steht in jeder Zeile h = 1, und erst der Klassen-Modus zeigt ein Muster.

Anwendung

Praxisbeispiel: Notenspiegel einer Mathematikarbeit

Eine Lehrerin hat in einer Mathematikarbeit 24 Noten vergeben und will den Notenspiegel für den Elternabend aufbereiten. Sie wählt „Urliste“ und trägt 1 1 2 2 2 2 2 3 3 3 3 3 3 3 3 4 4 4 4 4 5 5 5 6 ein, mit drei Nachkommastellen.

Der Rechner zählt die absolute Häufigkeit h = 2, 5, 8, 5, 3 und 1 für die Noten 1 bis 6 und macht daraus die relative Häufigkeit f = 0,083, 0,208, 0,333, 0,208, 0,125 und 0,042.

Die Drei ist mit h = 8 und f = 0,333 der Modalwert, die kumulierte Spalte zeigt F(2) = 0,292, F(3) = 0,625 und F(4) = 0,833.

Die Mitte der Verteilung liegt damit bei der Note 3, denn F(2) bleibt unter 0,5 und F(3) überschreitet es. Notenspiegel von 24 Arbeiten mit h gleich 2, 5, 8, 5, 3 und 1; die Summe der gerundeten f ist 0,999 statt 1 Die Summenzeile zeigt 0,999. Die Rundungsdifferenz von −0,001 kommt nur vom Runden, die ungerundeten Brüche ergeben 24 / 24 = 1.

Den Eltern nennt die Lehrerin Prozentwerte: 33,3 % Dreien und 83,3 % der Arbeiten mindestens Note 4. Da nur 4 von 24 Arbeiten (16,7 %) schlechter ausfielen, sieht sie keinen Anlass, die Arbeit als zu schwer einzustufen.

Zur Gegenprobe gibt sie im Einzelwert-Modus h = 8 und n = 24 ein und erhält f = 0,333 mit dem gekürzten Bruch 1/3: Ein Drittel der Klasse hat eine Drei. Das reicht für den Elternabend, mehr Stellen brächten keinen Erkenntnisgewinn.

Eine zweite Klasse vergleicht sie erst mit eigener Tabelle, denn bei n = 24 schwankt jede Zeile spürbar.

Fallstricke

Sechs typische Fehler bei der relativen Häufigkeit

Fehler 1: h und n verwechseln oder die falsche Grundmenge wählen. Wer 12 durch 48 teilt, obwohl nicht alle 48 befragt wurden, erhält einen falschen Anteil.

Der Stichprobenumfang n zählt alle Beobachtungen, nicht nur die der gesuchten Ausprägung; der Rechner weist h > n deshalb ab. Fehler 2: relative Häufigkeit und Wahrscheinlichkeit gleichsetzen.

Bei 20 Würfen mit fünf Sechsen ist f = 0,25, die theoretische Wahrscheinlichkeit aber 1/6 = 0,167. Bei n = 20 ist so eine Abweichung normal. Fehler 3: die Summe 0,999 für einen Rechenfehler halten und einzelne Zeilen zurechtbiegen.

Drei gleiche Drittel ergeben gerundet 0,999. Nenne die Rundung oder nimm mehr Stellen. Fehler 4: kumulierte Häufigkeiten bei reinen Namen wie Farben deuten.

Dort hängt F(blau) von der zufälligen Reihenfolge der Liste ab; sinnvoll ist F nur bei geordneten Merkmalen wie Noten oder Größenklassen. Fehler 5: das Ergebnis doppelt in Prozent umrechnen. f = 0,25 sind 25 %, nicht 2.500 %.

Der Rechner zeigt f und Prozent deshalb nebeneinander. Fehler 6: Werte auf der Klassengrenze falsch zuordnen.

Mit Klassenbreite 10 gehört 180 cm zu „180 bis unter 190“, nicht zu „170 bis unter 180“; wer von Hand die obere Grenze mitzählt, verschiebt h um 1 und das Histogramm gleich mit.

Nächster Schritt

Häufigkeit-Rechner: Fazit, Quellen und Grenzen

Der Rechner zählt eine Urliste aus und liefert die Tabelle mit absoluter, relativer, prozentualer und kumulierter Häufigkeit samt Modalwert und Summenkontrolle; im Einzelwert-Modus rechnet er f = h / n mit gekürztem Bruch, bei Klassen mit Häufigkeitsdichte.

Alle Zahlen stammen aus der Rechenfunktion dieser Seite. Grundlage sind die Definitionen in Fahrmeir u. a., Statistik – Der Weg zur Datenanalyse (8.

Aufl., Springer 2016, Kapitel 2), und die Leitidee „Daten und Zufall“ der KMK-Bildungsstandards Mathematik (Fassung vom 23.06.2022).

Grenzen: Der Rechner prüft weder, ob die Stichprobe repräsentativ ist, noch Tippfehler in Kategorien, und die relative Häufigkeit gilt zunächst nur für die vorliegende Stichprobe.

Als nächste Schritte bieten sich Durchschnitt und Median für Lagemaße, die Wahrscheinlichkeit für die theoretische Seite des Würfelbeispiels und der Prozentrechner für Anteile ohne Liste an; für Wahlergebnisse mit Stimmenzahlen gibt es den Stimmen-Prozent-Umrechner.

Vertiefung

Rechenbeispiele: Urliste, Einzelwert und Klassen

Beispiel 1 · Einfach · f = 0,25 = 25 % = 1/4; Gegenhäufigkeit 0,75

12 von 48 Befragten

Was liegt vor?
Einzelwert: absolute Häufigkeit h und Umfang n
Absolute Häufigkeit h
12
Stichprobenumfang n (alle Beobachtungen)
48

Beispiel 2 · Mittel · f = 0,15 = 15 % = 3/20

30 von 200 Rückmeldungen

Was liegt vor?
Einzelwert: absolute Häufigkeit h und Umfang n
Absolute Häufigkeit h
30
Stichprobenumfang n (alle Beobachtungen)
200

Beispiel 3 · Komplex · h = 2, 5, 8, 5, 3, 1; Modalwert 3 (f = 0,333); F(4) = 0,833; Summe der gerundeten f = 0,999

Notenspiegel mit 24 Arbeiten

Was liegt vor?
Urliste (Zahlen oder Kategorien)
Urliste (alle Beobachtungen)
1 1 2 2 2 2 2 3 3 3 3 3 3 3 3 4 4 4 4 4 5 5 5 6
Nachkommastellen der relativen Häufigkeit
3 Nachkommastellen

Beispiel 4 · Komplex · h = 2, 3, 4, 3, 3, 5; f(6) = 0,25 (Modalwert); F(3) = 0,45; Summe f = 1

20 Würfelwürfe

Was liegt vor?
Urliste (Zahlen oder Kategorien)
Urliste (alle Beobachtungen)
1 1 2 2 2 3 3 3 3 4 4 4 5 5 5 6 6 6 6 6
Nachkommastellen der relativen Häufigkeit
3 Nachkommastellen

Beispiel 5 · Komplex · rot h = 3, f = 0,5; blau h = 2, f = 0,333; grün h = 1, f = 0,167

Kategorien rot, blau, grün

Was liegt vor?
Urliste (Zahlen oder Kategorien)
Urliste (alle Beobachtungen)
rot, blau, rot, grün, blau, rot
Nachkommastellen der relativen Häufigkeit
3 Nachkommastellen

Beispiel 6 · Komplex · h = 1, 2, 6, 3, 2, 1; stärkste Klasse 170 bis unter 180 (f = 0,4; Dichte 0,04)

15 Körpergrößen in Klassen

Was liegt vor?
Zahlen in Klassen einteilen (Klassenbreite)
Urliste (alle Beobachtungen)
158 162 165 170 171 172 175 175 178 180 181 185 190 193 201
Klassenbreite
10
Nachkommastellen der relativen Häufigkeit
3 Nachkommastellen

Weiterführende Rechner und Themen

Alle Anschlussrechner und Vertiefungen in einem klaren Modul, damit du direkt zur nächsten sinnvollen Berechnung springen kannst.

Kombinatorik-RechnerPermutationen, Kombinationen und Variationen mit und ohne Wiederholung berechnen, Binomialkoeffizient.StandardabweichungsrechnerMittelwert, Varianz und Standardabweichung für Population oder Stichprobe berechnen.Spannweite-RechnerSpannweite R = Maximum − Minimum aus einer Zahlenliste berechnen – mit Median, Mittelwert, Minimum, Maximum und sortierter Werteliste.Gini-Koeffizient-RechnerGini-Koeffizient berechnen aus einer Werteliste oder aus klassierten Daten: Gini, normierter Gini, Gini-Index, Anteil der obersten 10 und 20 Prozent und Lorenzkurven-Tabelle mit Rechenweg.Odds-Ratio-RechnerOdds Ratio (Chancenverhältnis) aus der Vierfeldertafel berechnen: mit Konfidenzintervall nach Woolf, Haldane-Korrektur bei Nullzellen, relativem Risiko, Risikodifferenz und NNT.Freiheitsgrade-RechnerFreiheitsgrade (df) für t-Test, Welch-Test, χ²-Unabhängigkeits- und Anpassungstest, ANOVA, Regression und Varianz berechnen – mit Formel, kritischem Wert zum Signifikanzniveau α und Tabelle der kritischen t-Werte.Benford-RechnerBenfordsches Gesetz prüfen: Zahlenliste einfügen und die führenden Ziffern mit der Sollverteilung vergleichen – mit χ²-Test, MAD, Tabelle je Ziffer und Hinweisen zu Listengröße und Aussagekraft.Konfidenzintervall-RechnerKonfidenzintervall berechnen für Mittelwert (t- oder z-Intervall, auch aus Rohdaten) und Anteil (Wilson und Wald) bei 80 bis 99,9 % Niveau – mit Rechenweg und benötigter Stichprobengröße.t-Test-Rechnert-Test berechnen: Einstichproben-, gepaarter und Zweistichproben-Test (Welch oder gleiche Varianzen) aus Kennzahlen oder Rohdaten – mit p-Wert, kritischem t-Wert, Entscheidung und t-Tabelle.Lineare-Regression-RechnerLineare Regression berechnen aus x- und y-Werten: Regressionsgerade, Bestimmtheitsmaß R², Korrelation r, Standardfehler, Prognose und Residuentabelle, wahlweise auch exponentiell, logarithmisch, als Potenz oder quadratisch.Stichprobengröße-RechnerStichprobengröße berechnen für Umfragen (Anteil), Mittelwerte und den Vergleich zweier Gruppen (Poweranalyse) – mit Endlichkeitskorrektur, Rücklaufquote, Rechenweg und Tabelle nach Fehlermarge und Konfidenzniveau.Kritischer-Wert-RechnerKritischen Wert und p-Wert für z, t, χ² und F berechnen: ein- oder zweiseitig, mit Ablehnungsbereich, Testentscheidung und t-Wert-Tabelle.Korrelation-RechnerKorrelation berechnen: Pearson r oder Spearman ρ aus Datenpaaren – mit r², t-Test, p-Wert, Konfidenzintervall nach Fisher, Stärke nach Cohen, Regressionsgerade und Rechentabelle je Paar.Varianz-RechnerVarianz und Standardabweichung einer Datenmenge berechnen – Stichprobenvarianz und Grundgesamtheit.Zufallszahlen-GeneratorZufallszahlen in einem frei wählbaren Bereich erzeugen – mit oder ohne Wiederholung und optional aufsteigend sortiert, etwa für Lottozahlen, Losentscheide und Stichproben.

Weiternutzung

Grafiken weiterverwenden

Alle 3 Grafiken dieser Seite darfst du in eigenen Artikeln und Beiträgen verwenden.

Nutzung frei, wenn du rechner-portal.de als Quelle verlinkst. CC BY 4.0

  • Urliste 2, 3, 3, 5, 5, 5 wird zur Häufigkeitstabelle: h gleich 1, 2 und 3, f gleich 0,167, 0,333 und 0,5, F endet bei 1

    Urliste 2; 3; 3; 5; 5; 5 wird zur Häufigkeitstabelle

    760 × 360 Pixel · Schaubild

    Herunterladen

    Einbettungscode

    HTML zum Einbinden

    <a href="https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner">
      <img src="https://rechner-portal.de/images/mathematik/haeufigkeit-rechner-urliste.svg"
           alt="Urliste 2, 3, 3, 5, 5, 5 wird zur Häufigkeitstabelle: h gleich 1, 2 und 3, f gleich 0,167, 0,333 und 0,5, F endet bei 1"
           width="760" height="360">
    </a>
    <p>Quelle: <a href="https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner">Urliste 2; 3; 3; 5; 5; 5 wird zur Häufigkeitstabelle auf Rechner-Portal</a></p>

    Textbaustein für die Bildunterschrift

    Quelle: Rechner-Portal (rechner-portal.de) — https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner
  • Notenspiegel von 24 Arbeiten: h gleich 2, 5, 8, 5, 3 und 1, Modalwert Note 3, Summe der gerundeten f gleich 0,999 statt 1

    Notenspiegel mit Modalwert und Rundungsdifferenz

    760 × 360 Pixel · Schaubild

    Herunterladen

    Einbettungscode

    HTML zum Einbinden

    <a href="https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner">
      <img src="https://rechner-portal.de/images/mathematik/haeufigkeit-rechner-notenspiegel.svg"
           alt="Notenspiegel von 24 Arbeiten: h gleich 2, 5, 8, 5, 3 und 1, Modalwert Note 3, Summe der gerundeten f gleich 0,999 statt 1"
           width="760" height="360">
    </a>
    <p>Quelle: <a href="https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner">Notenspiegel mit Modalwert und Rundungsdifferenz auf Rechner-Portal</a></p>

    Textbaustein für die Bildunterschrift

    Quelle: Rechner-Portal (rechner-portal.de) — https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner
  • Klassenbildung: 15 Körpergrößen von 158 bis 201 cm mit Klassenbreite 10 ergeben sechs Klassen mit h gleich 1, 2, 6, 3, 2 und 1

    Körpergrößen in Klassen der Breite 10

    760 × 360 Pixel · Schaubild

    Herunterladen

    Einbettungscode

    HTML zum Einbinden

    <a href="https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner">
      <img src="https://rechner-portal.de/images/mathematik/haeufigkeit-rechner-klassen.svg"
           alt="Klassenbildung: 15 Körpergrößen von 158 bis 201 cm mit Klassenbreite 10 ergeben sechs Klassen mit h gleich 1, 2, 6, 3, 2 und 1"
           width="760" height="360">
    </a>
    <p>Quelle: <a href="https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner">Körpergrößen in Klassen der Breite 10 auf Rechner-Portal</a></p>

    Textbaustein für die Bildunterschrift

    Quelle: Rechner-Portal (rechner-portal.de) — https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner

Quellen, Transparenz und Haftung

Haftungsausschluss

Die Ergebnisse dieses Rechners sind Orientierungswerte und ersetzen keine professionelle Beratung. Für verbindliche Entscheidungen – insbesondere in finanziellen, gesundheitlichen oder rechtlichen Angelegenheiten – empfehlen wir die Einholung fachkundiger Beratung. Aktuelle Vertrags-, Produkt- und Regulierungsdaten können von den Rechenwerten abweichen.

Rechnerspezifische Grenzen: Der Rechner zählt und teilt die eingegebenen Daten. Er prüft nicht, ob die Stichprobe repräsentativ ist, und eine relative Häufigkeit ist erst bei großem Umfang ein guter Schätzwert für eine Wahrscheinlichkeit.

Quelle: Statistik: Häufigkeitsverteilungen nach Fahrmeir u. a. (2016), Kapitel 2; Stand Oktober 2026.

Stand: 2026-10-12

Externe Fachquellen
Qualitätsnachweise
Verantwortlich
Kilian Achatz
Herausgeber
Rechner-Portal
Letzte fachliche Prüfung
12. Oktober 2026
Fachbereich
Mathematik / Statistik
Formeln basieren auf
Relative Häufigkeit f(a_j) = h(a_j) / n mit Σ h = n und Σ f = 1; Prozent = f · 100; kumuliert H(a_j) = h(a_1) + … + h(a_j) und F(a_j) = H(a_j) / n; Häufigkeitsdichte klassierter Daten = f_j / Klassenbreite.
Zitation & Richtlinien

APA-Format

Rechner-Portal (2026). Relative Häufigkeit berechnen. Abgerufen von https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner

Harvard-Format

Rechner-Portal, 2026. Relative Häufigkeit berechnen. Available at: https://rechner-portal.de/mathematik/statistik/haeufigkeit-rechner

Werbestatus

Mögliche Werbung hat keinen Einfluss auf Rechenweg, Ergebnis oder Priorisierung dieses Rechners.