Zum Hauptinhalt springen

Korrelation berechnen: Pearson, Spearman, p-Wert, r²

MathematikStand Noch keine Bewertung
Welche Korrelation willst du berechnen?
Signifikanzniveau α
Testrichtung
Regressionsgerade anzeigen
Anzeige

Kurzantwort

Die Korrelation misst Stärke und Richtung eines Zusammenhangs zwischen zwei Messreihen auf einer Skala von −1 bis +1. Sie sagt nichts über Ursache und Wirkung, und ein hohes r bei wenigen Paaren kann Zufall sein, deshalb gehören p-Wert und Konfidenzintervall dazu.

Korrelation berechnen: Pearson r oder Spearman ρ aus Datenpaaren mit r², p-Wert

Kilian AchatzFachredaktion Mathematik
Geprüft: Review-Team Rechner-Portal (Okt. 2026)Stand:

Überblick

Was berechnet der Korrelation-Rechner?

Starte mit der kurzen Einordnung, bevor du Eingaben und Ergebnis interpretierst.

Die Korrelation misst, wie stark und in welche Richtung zwei Messreihen zusammenhängen. Der Korrelation-Rechner berechnet aus Datenpaaren den Pearson-Koeffizienten r für lineare Zusammenhänge oder die Spearman-Rangkorrelation ρ für Ränge, Ausreißer und gekrümmte Verläufe.

Dazu liefert er das Bestimmtheitsmaß r², die Prüfgröße t, den p-Wert, ein Konfidenzintervall nach Fisher, die Stärke nach Cohen und die Regressionsgerade.

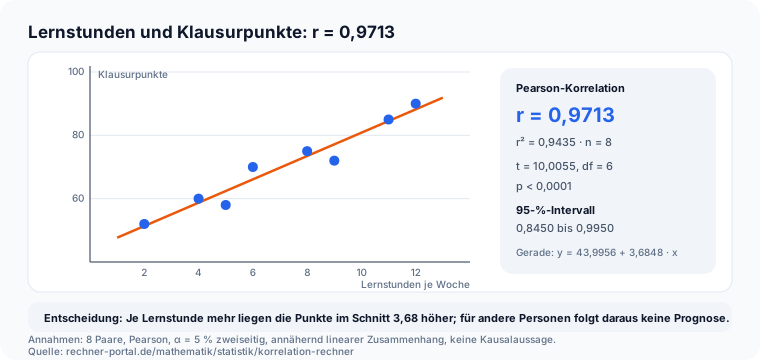
Im Standardfall hängen die Klausurpunkte von 8 Studierenden (52 bis 90) an ihren wöchentlichen Lernstunden (2 bis 12): r = 0,9713, r² = 0,9435 und p unter 0,0001, das 95-%-Intervall reicht von 0,8450 bis 0,9950.

Ein Koeffizient allein reicht nicht. r liegt immer zwischen −1 und +1, wobei +1 eine perfekte gleichsinnige und −1 eine perfekte gegensinnige Gerade bedeutet; 0 heißt kein linearer Zusammenhang.

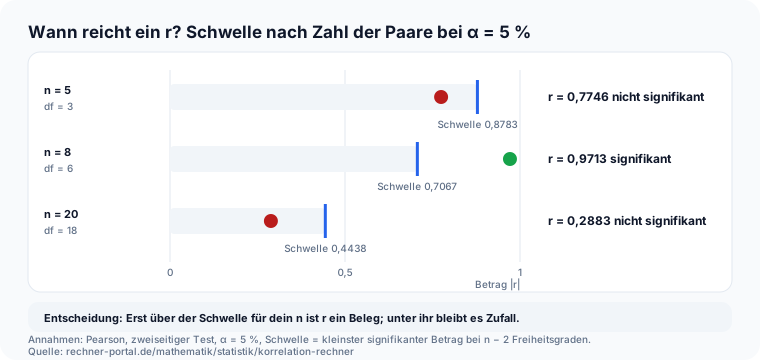
Ob ein Wert über dem Zufall liegt, entscheidet der Test auf Zusammenhang mit df = n − 2: Bei 5 Paaren ist r = 0,7746 noch nicht signifikant (p = 0,1240), weil erst |r| ab 0,8783 genügt, bei 8 Paaren genügen 0,7067.

Die Zahl der Paare entscheidet also mit: Je kleiner n, desto höher muss |r| sein, damit der Test einen Zusammenhang anerkennt. Deshalb zeigt der Rechner neben r immer den p-Wert, das Intervall und den kleinsten signifikanten Betrag.

Der Rechner richtet sich an Studierende, Forschende und alle, die Messreihen aus Excel oder Umfragen auswerten: Die Spalten lassen sich direkt einfügen. Er beschreibt den Zusammenhang der eingegebenen Daten, nicht dessen Ursache.
Eingaben

x-Werte, y-Werte, Verfahren, Signifikanzniveau und Testrichtung eingeben

Hier siehst du, welche Werte erwartet werden und wie die Felder zusammenhängen.

Wähle zuerst, welche Korrelation du berechnen willst: Pearson für metrische Daten mit annähernd linearem Zusammenhang, Spearman für Rangdaten, Ausreißer oder Kurven. Pearson verlangt metrische Daten; bei Spearman genügt es, wenn sich die Werte ordnen lassen, etwa Schulnoten oder Platzierungen.

Füge dann die x-Werte (erste Messreihe) und die y-Werte (zweite Messreihe) als Listen ein, getrennt durch Semikolon, Leerzeichen oder Zeilenumbruch; Dezimalkomma ist erlaubt, und eine Spalte aus Excel lässt sich direkt einkopieren.

Beide Listen müssen gleich lang sein, der erste y-Wert gehört zum ersten x-Wert, und es braucht mindestens 3 Paare, höchstens 2.000. Das Signifikanzniveau α (10, 5 oder 1 %) legt zugleich das Konfidenzniveau fest: 5 % ergibt ein 95-%-Intervall.

Die Testrichtung bleibt zweiseitig, solange du die Richtung des Zusammenhangs nicht vor der Erhebung festgelegt hast. Bei Pearson kannst du die Regressionsgerade anzeigen oder ausblenden.

Sind alle x- oder alle y-Werte gleich, ist die Korrelation nicht definiert, und der Rechner meldet das mit einem Hinweis statt mit einer Zahl.

Praxisfälle

Korrelation nach Fall berechnen: Pearson, Spearman, Signifikanz

Sieben typische Suchfragen zur Korrelation, jede mit den Eingaben und dem nachgerechneten Ergebnis aus dem Rechner oben.

  1. Korrelation aus 8 Wertepaaren

    „Wie stark hängen Lernstunden und Klausurpunkte zusammen?“

    Eingabe
    Pearson, x 2;4;5;6;8;9;11;12, y 52;60;58;70;75;72;85;90, α 5 %
    Ergebnis
    r = 0,9713 | r² = 0,9435 | p < 0,0001 | Intervall 0,8450 bis 0,9950
  2. Korrelation mit nur 5 Paaren

    „Ist r = 0,7746 bei 5 Paaren signifikant?“

    Eingabe
    Pearson, x 1;2;3;4;5, y 2;4;5;4;5, α 5 %, zweiseitig
    Ergebnis
    r = 0,7746 | p = 0,1240 | nicht signifikant | nötig: |r| ab 0,8783
  3. Einseitiger Test

    „Wie ändert sich p beim einseitigen Test?“

    Eingabe
    Pearson, x 1;2;3;4;5, y 2;4;5;4;5, α 5 %, einseitig
    Ergebnis
    p = 0,0620 statt 0,1240 | weiterhin nicht signifikant bei 5 %
  4. Spearman-Rangkorrelation (IQ und Fernsehen)

    „Wie berechne ich Spearman ρ für IQ und Fernsehstunden?“

    Eingabe
    Spearman, x 86;97;99;100;101;103;106;110;112;113, y 0;20;28;27;50;29;7;17;6;12
    Ergebnis
    ρ = −0,1758 | p = 0,6272 | kein nachweisbarer Zusammenhang
  5. Spearman bei Rangbindungen

    „Wie geht Spearman mit gleichen Werten um?“

    Eingabe
    Spearman, x 3;5;5;8;9;12, y 2;6;4;7;9;9, α 5 %
    Ergebnis
    ρ = 0,9706 | p = 0,0013 | mittlere Ränge bei Bindungen
  6. Ausreißer verzerrt Pearson

    „Wie stark ändert ein Ausreißer die Korrelation?“

    Eingabe
    Pearson, x 1 bis 8, y 1 bis 7 und 30
    Ergebnis
    r = 0,7377 (p = 0,0367) | Spearman ρ = 1,0000
  7. Kein linearer Zusammenhang bei y = x²

    „Warum ist r = 0 bei einer Parabel?“

    Eingabe
    Pearson, x −3 bis 3, y 9;4;1;0;1;4;9
    Ergebnis
    r = 0,0000 | p = 1,0000 | trotz exakter Abhängigkeit

Berechnung

Korrelationskoeffizient Formel: Pearson r, Spearman ρ, t-Test und Fisher-Intervall

Verstehe den Formelweg.

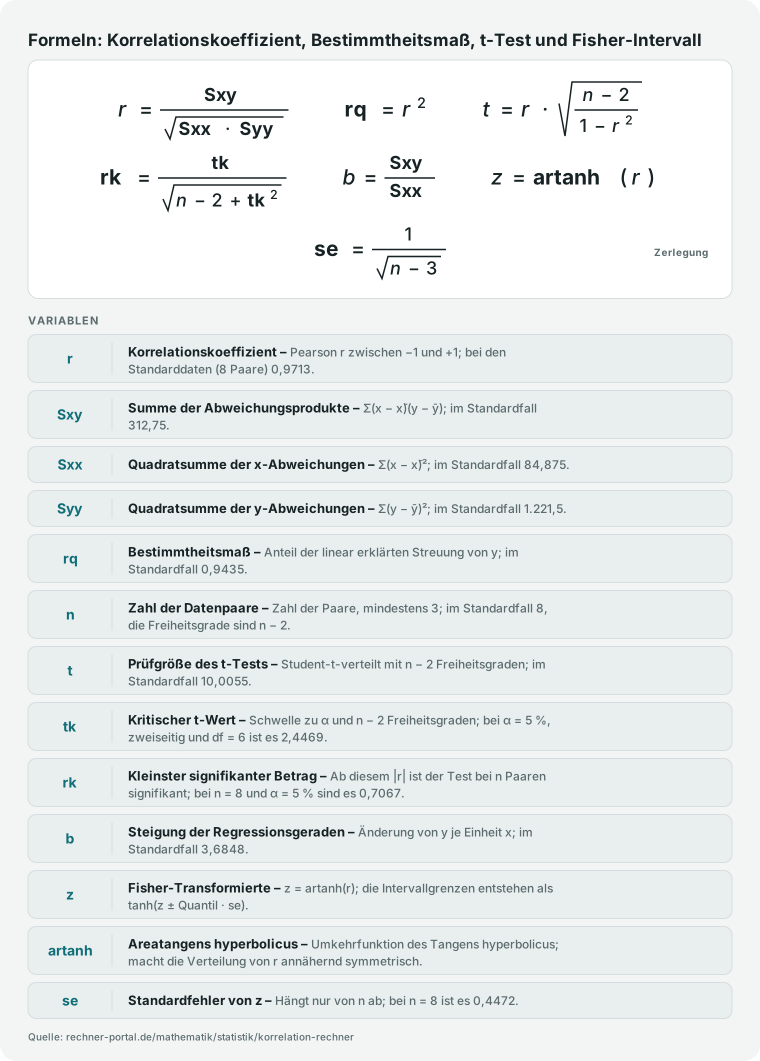
Pearson bildet aus den Abweichungen vom Mittelwert drei Summen: Sxy = Σ(x − x̄)(y − ȳ), Sxx = Σ(x − x̄)² und Syy = Σ(y − ȳ)². Daraus folgt r = Sxy ÷ √(Sxx · Syy).

Im Standardfall sind x̄ = 7,1250 und ȳ = 70,2500, Sxy = 312,7500, Sxx = 84,8750 und Syy = 1.221,5000, also r = 312,75 ÷ √(84,875 · 1.221,5) = 0,9713.

Die Regressionsgerade hat die Steigung b = Sxy ÷ Sxx = 3,6848 und den Achsenabschnitt a = ȳ − b · x̄ = 43,9956. Streudiagramm der 8 Datenpaare mit Regressionsgerade y = 43,9956 + 3,6848 · x, Pearson r = 0,9713 und r² = 0,9435 Spearman rechnet dasselbe mit Rängen; gleiche Werte erhalten den mittleren Rang.

Der Test auf Zusammenhang nutzt t = r · √((n − 2) ÷ (1 − r²)) mit df = n − 2; im Standardfall ist t = 10,0055 bei df = 6.

Das Konfidenzintervall entsteht über die Fisher-Transformation: z = artanh(r), Standardfehler 1 ÷ √(n − 3), Grenzen tanh(z ± z₁₋α/₂ · SE). Den kleinsten signifikanten Betrag liefert |r| = t ÷ √(n − 2 + t²) mit dem kritischen t-Wert.

Bei |r| = 1 wird der Nenner von t gleich 0; dann ist p = 0, und ein Konfidenzintervall gibt es nicht.

Formelgrafik: Pearson-Korrelation aus Sxy, Sxx und Syy, Bestimmtheitsmaß, t-Prüfgröße, kleinster signifikanter Betrag, Steigung und Fisher-Transformation
Bei 8 Paaren mit Sxy = 312,75, Sxx = 84,875 und Syy = 1.221,5 ist r = 0,9713 und r² = 0,9435; t = 10,0055 bei df = 6, und ab |r| = 0,7067 wäre der Test bei α = 5 % signifikant.

Nachschlagen

Kleinster signifikanter Betrag |r| nach Zahl der Paare

Je weniger Paare, desto größer muss |r| sein, damit der zweiseitige Test auf Zusammenhang signifikant wird. Die Werte stammen aus derselben Funktion wie der Rechner oben und gelten für Pearson; bei Spearman sind sie eine Näherung.

Kleinster signifikanter Betrag der Korrelation bei zweiseitigem Test für α = 0,10, 0,05 und 0,01
Zahl der Paare nFreiheitsgrade dfα = 0,10α = 0,05α = 0,01
530,80540,87830,9587
860,62150,70670,8343
1080,54940,63190,7646
15130,44090,51400,6411
20180,37830,44380,5614
30280,30610,36100,4629
50480,23530,27870,3610
100980,16540,19660,2565

Annahmen: bivariate Normalverteilung, zweiseitiger Test, r = t ÷ √(n − 2 + t²). Stand: 11.10.2026.

Stärke der Korrelation nach Cohen und gemeinsame Streuung r²

Cohen (1988) ordnet |r| ab 0,1 als kleinen, ab 0,3 als mittleren und ab 0,5 als großen Effekt ein. Das Bestimmtheitsmaß r² gibt an, welcher Anteil der Streuung von y linear mit x zusammenhängt.

Einordnung von |r| nach den Konventionen von Cohen mit Bestimmtheitsmaß r²
Betrag |r|r² (gemeinsame Streuung)Einordnung nach Cohen
0,11 %klein
0,39 %mittel
0,525 %groß
0,749 %groß
0,981 %groß

Annahmen: Konventionen als sprachliche Einordnung, kein Gütekriterium für den Einzelfall. Stand: 11.10.2026.

95-%-Konfidenzintervall der Korrelation nach Fisher

Das Intervall wird mit wachsendem n schmaler und ist nicht symmetrisch um r. Bei kleinem n und mittlerem r reicht es bis in den negativen Bereich. Die Grenzen stammen aus derselben Funktion wie der Rechner oben.

Untere und obere Grenze des 95-%-Konfidenzintervalls für r = 0,3, 0,5 und 0,7 bei n = 10, 20, 50 und 100
Beobachtetes rn = 10n = 20n = 50n = 100
0,3−0,41 bis 0,78−0,16 bis 0,660,02 bis 0,530,11 bis 0,47
0,5−0,19 bis 0,860,07 bis 0,770,26 bis 0,680,34 bis 0,63
0,70,13 bis 0,920,37 bis 0,870,52 bis 0,820,58 bis 0,79

Annahmen: Fisher-Transformation z = artanh(r), SE = 1 ÷ √(n − 3), Pearson, α = 0,05. Stand: 11.10.2026.

Expertenmodus

Häufige Fragen zur Korrelation

Spezielle Fragen geklärt. Tiefer verstehen.

Wie berechne ich die Korrelation von Hand?

Du bildest zuerst die Mittelwerte x̄ und ȳ, dann pro Datenpaar die Abweichungen und ihr Produkt. Aus den Summen Sxy = Σ(x − x̄)(y − ȳ), Sxx = Σ(x − x̄)² und Syy = Σ(y − ȳ)² folgt r = Sxy ÷ √(Sxx · Syy).

Mit x = 1, 2, 3, 4, 5 und y = 2, 4, 5, 4, 5 sind x̄ = 3 und ȳ = 4, Sxy = 6, Sxx = 10 und Syy = 6, also r = 6 ÷ √60 = 0,7746. Das Bestimmtheitsmaß r² = 0,6000 sagt, dass 60 % der Streuung von y linear mit x zusammenhängen.

Die Rechentabelle des Rechners zeigt jede dieser Zwischenrechnungen je Paar, sodass du eine Handrechnung Zeile für Zeile vergleichen kannst.

Vergiss nicht, danach den Test auf Zusammenhang zu machen: Bei nur 5 Paaren ergibt r = 0,7746 einen p-Wert von 0,1240, also kein gesichertes Ergebnis. Der Rechner nimmt dir auch das ab.

Wie berechne ich die Korrelation in Excel?

Die Funktion KORREL(Matrix1; Matrix2) gibt den Korrelationskoeffizienten zweier Zellbereiche zurück und liefert denselben Pearson-Wert wie dieser Rechner; bei den Standarddaten (8 Paare) ergibt beides 0,9713.

Du markierst die beiden Spalten, trägst sie als Bereiche ein und erhältst eine einzelne Zahl, aber weder den p-Wert noch ein Konfidenzintervall noch die Stärke.

Für die Spearman-Rangkorrelation bildest du zuerst für beide Spalten die Ränge, bei gleichen Werten die mittleren Ränge, und wendest KORREL auf die Ränge an; der Rechner macht das in einem Schritt und zeigt die Ränge in der Tabelle.

Wichtig ist, dass beide Bereiche gleich lang sind und die Zeilen zusammengehören, sonst stimmt die Zuordnung der Paare nicht. Eine Excel-Spalte kannst du direkt in die Felder x-Werte und y-Werte einfügen.

Text in den Daten meldet der Rechner mit einem Hinweis, und fehlende Werte fallen als ungleich lange Listen auf.

Was bedeutet eine Korrelation von 0,5?

Nach der Konvention von Cohen (1988) ist |r| = 0,5 ein großer Effekt, 0,3 ein mittlerer und 0,1 ein kleiner. Das r² von 0,25 sagt, dass 25 % der Streuung von y linear mit x zusammenhängen, die übrigen 75 % haben andere Ursachen.

Ob ein r von 0,5 überhaupt über dem Zufall liegt, hängt von der Zahl der Paare ab: Bei 8 Paaren muss |r| mindestens 0,7067 betragen, damit ein zweiseitiger Test bei α = 5 % signifikant wird, bei 10 Paaren 0,6319 und bei 20 Paaren 0,4438.

Mit r = 0,5 und n = 20 wäre das Ergebnis also gerade signifikant, mit n = 8 oder n = 10 nicht. Die Einordnung als „groß“ ist eine Konvention und kein Urteil über deinen Fall; in manchen Fächern ist schon 0,3 praktisch bedeutsam.

Der Rechner zeigt neben der Stärke immer den kleinsten signifikanten Betrag für dein n an.

Pearson oder Spearman: Welche Korrelation passt?

Pearson misst, wie gut die Punkte auf einer Geraden liegen, und verlangt metrische, annähernd normalverteilte Daten. Spearman rechnet mit den Rängen, erfasst jeden gleichsinnigen Zusammenhang und ist unempfindlich gegen Ausreißer.

Bei x = 1 bis 8 und y = 1, 4, 9, … , 64 ist Pearson r = 0,9762, Spearman ρ = 1,0000, weil die Rangfolge perfekt gleichsinnig ist.

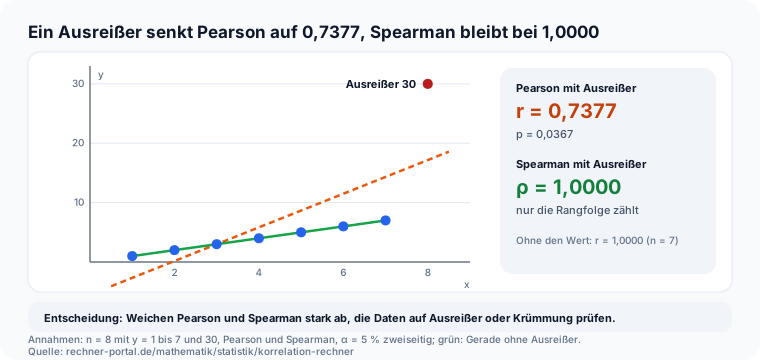
Ein Ausreißer verzerrt Pearson stärker: Bei x = 1 bis 8 und y = 1 bis 7 plus einem Wert 30 liefert Pearson 0,7377, Spearman bleibt bei 1,0000. Rangdaten wie Schulnoten oder Platzierungen gehören zu Spearman.

Bei Bindungen vergibt der Rechner mittlere Ränge. Liegen beide Koeffizienten weit auseinander, lohnt ein Blick auf die Daten: Dann ist der Zusammenhang gekrümmt oder von einzelnen Punkten geprägt.

Der Rechner zeigt dir beides, du wechselst das Verfahren mit einem Klick und siehst den Unterschied sofort.

Wann ist eine Korrelation signifikant?

Wenn der p-Wert des Tests auf Zusammenhang unter dem Signifikanzniveau α liegt, meist 5 %. Der Test nutzt t = r · √((n − 2) ÷ (1 − r²)) mit df = n − 2; je kleiner n, desto größer muss |r| sein.

Bei 5 Paaren genügt erst |r| ab 0,8783, bei 8 Paaren ab 0,7067, bei 10 Paaren ab 0,6319 und bei 20 Paaren ab 0,4438.

Das erklärt, warum r = 0,7746 bei 5 Paaren mit p = 0,1240 nicht signifikant ist, r = 0,2883 bei 20 Paaren mit p = 0,2178 ebenfalls nicht, aber r = 0,9713 bei 8 Paaren mit p unter 0,0001 sehr deutlich.

Signifikant heißt nur, dass der Zusammenhang schwerlich Zufall ist, nicht, dass er groß oder wichtig wäre: Bei sehr vielen Paaren wird schon ein winziges r signifikant.

Der Rechner nennt p, die Prüfgröße t, df und den kleinsten signifikanten Betrag und sagt in einem Satz, ob dein Ergebnis über α liegt.

Wie lese ich das Konfidenzintervall der Korrelation?

Das Intervall nennt den Bereich, in dem die wahre Korrelation der Grundgesamtheit mit der gewählten Sicherheit liegt. Es entsteht über die Fisher-Transformation z = artanh(r) mit dem Standardfehler 1 ÷ √(n − 3) und ist nicht symmetrisch um r.

Bei den Standarddaten reicht es von 0,8450 bis 0,9950, bei den 5 Paaren mit r = 0,7746 dagegen von −0,3401 bis 0,9842.

Weil das Intervall dort die 0 enthält, passt es zum nicht signifikanten p-Wert von 0,1240; ein Intervall ohne 0 entspricht einem signifikanten Ergebnis.

Bei 20 Paaren und r = 0,2883 reicht es von −0,1768 bis 0,6481 und ist damit immer noch sehr breit. Mehr Paare machen das Intervall schmaler.

Für Spearman gibt der Rechner kein Intervall aus, und bei |r| = 1 oder weniger als 4 Paaren gibt es keines, weil dann die Fisher-Transformation nicht definiert ist.

Heißt Korrelation, dass eine Größe die andere verursacht?

Nein. Eine Korrelation zeigt nur, dass sich zwei Größen gemeinsam verändern, und kann drei Ursachen haben: A wirkt auf B, B wirkt auf A, oder eine dritte Größe beeinflusst beide, dazu kommt reiner Zufall.

Bei Lernstunden und Klausurpunkten mit r = 0,9713 ist plausibel, dass Lernen hilft; ausgeschlossen ist aber nicht, dass Vorwissen oder Motivation beides erhöhen.

Die Statistik kann das nicht trennen, nur ein Versuchsaufbau, in dem die Lernzeit zufällig zugeteilt wird. Auch das Bestimmtheitsmaß r² = 0,9435 sagt nur, welcher Anteil der Streuung linear zusammenhängt, nicht welcher Anteil verursacht ist.

Die Regressionsgerade y = 43,9956 + 3,6848 · x beschreibt die Daten, sie ist keine Prognose für jede Person. Der Rechner weist deshalb in jedem Hinweis darauf hin und trennt sauber zwischen der Stärke des Zusammenhangs und seiner Deutung.

Wer Ursache und Wirkung klären will, braucht einen Versuchsaufbau mit zufälliger Zuteilung und Vergleichsgruppe.

Was passiert bei Rangbindungen und bei r = 1?

Bei Bindungen vergibt der Rechner für Spearman den mittleren Rang: Zwei gleiche Werte auf den Plätzen 2 und 3 erhalten beide den Rang 2,5.

Für x = 3, 5, 5, 8, 9, 12 und y = 2, 6, 4, 7, 9, 9 ergibt das ρ = 0,9706 mit p = 0,0013. ρ ist dann der Pearson-Koeffizient der mittleren Ränge.

Bei |r| = 1 liegen alle Punkte exakt auf einer Geraden, der Nenner von t wird 0, deshalb ist p = 0, und es gibt kein Konfidenzintervall.

Sind alle x-Werte oder alle y-Werte gleich, ist die Korrelation nicht definiert, weil die Varianz 0 ist; der Rechner nennt dann den Grund und rechnet nicht weiter. Das gilt auch bei weniger als 3 Paaren, ungleich langen Listen oder Text in den Daten.

So bekommst du nie stillschweigend eine Null oder eine erfundene Zahl, sondern eine Erklärung, was an der Eingabe fehlt. Fehlende Werte ergänzt du nicht mit Nullen, sondern lässt das ganze Paar weg.

Hinweise

Ergebnis lesen: Stärke nach Cohen, r², p-Wert und Ausreißer

Schnelle Qualitätsprüfung für dein Ergebnis.

Lies zuerst r und die Stärke, dann p und das Intervall.

Nach Cohen ist |r| ab 0,1 ein kleiner, ab 0,3 ein mittlerer und ab 0,5 ein großer Effekt; das ist eine Konvention, kein Urteil über deinen Fall. r² sagt, welcher Anteil der Streuung von y linear mit x zusammenhängt: 0,9435 heißt 94,35 %.

Das Intervall von 0,8450 bis 0,9950 zeigt, wie unsicher r bei 8 Paaren noch ist. Der kleinste signifikante Betrag steht daneben: bei 8 Paaren 0,7067, bei 10 Paaren 0,6319 und bei 20 Paaren 0,4438. Ausreißer: Bei x = 1 bis 8 und y = 1 bis 7 plus einem Wert 30 sinkt Pearson r auf 0,7377, während Spearman ρ bei 1,0000 bleibt Prüfe danach die Daten.

Ein einziger Ausreißer senkt Pearson stark: Ohne den Wert 30 wäre r bei den 7 Punkten x = 1 bis 7 genau 1; mit ihm bei x = 8 sinkt r auf 0,7377 (p = 0,0367), während Spearman bei 1,0000 bleibt, weil nur die Rangfolge zählt.

Liegen beide Koeffizienten weit auseinander, ist der Zusammenhang gekrümmt oder von Ausreißern geprägt. Die Rechentabelle am Ende zeigt jedes Paar mit Abweichungen und Produkten; ein auffällig großer Betrag in einer Zeile verrät den Ausreißer.

Anwendung

Praxisbeispiel: Lernstunden und Klausurpunkte von 8 Studierenden

So wird das Ergebnis in einer realen Entscheidung nutzbar.

Eine Studienberatung will wissen, ob die wöchentlichen Lernstunden mit der Klausurpunktzahl zusammenhängen. Sie hat 8 Studierende befragt: Lernstunden 2, 4, 5, 6, 8, 9, 11, 12 und Punkte 52, 60, 58, 70, 75, 72, 85, 90.

Im Rechner wählt sie Pearson, trägt beide Listen ein und lässt α = 5 % zweiseitig. Ergebnis: r = 0,9713, r² = 0,9435, t = 10,0055 bei df = 6, p unter 0,0001, 95-%-Intervall 0,8450 bis 0,9950, kleinster signifikanter Betrag 0,7067.

Die Gerade y = 43,9956 + 3,6848 · x sagt: Je Lernstunde mehr liegen die Punkte im Schnitt 3,68 höher. Signifikanzschwelle nach Zahl der Paare: bei 5 Paaren genügt |r| ab 0,8783, bei 8 ab 0,7067, bei 20 ab 0,4438; r = 0,7746 (n = 5) und r = 0,2883 (n = 20) liegen darunter, r = 0,9713 (n = 8) darüber Die Entscheidung: Die Beratung darf sagen, dass bei diesen 8 Studierenden mehr Lernzeit eng mit höheren Punkten zusammenging.

Sie darf nicht behaupten, dass jede zusätzliche Stunde 3,68 Punkte bringt, denn 8 Personen und ein Messzeitpunkt tragen keine Prognose für alle.

Mit nur 5 Paaren (r = 0,7746, p = 0,1240) oder 20 Paaren und r = 0,2883 (p = 0,2178) hätte sie nichts Gesichertes.

Fallstricke

Häufige Fehler bei der Korrelation: Kausalität, kleines n, r = 0, Ausreißer

Typische Anfängerfehler. Sicherer anwenden.

Der erste Fehler: Korrelation für Kausalität zu halten. r = 0,9713 zwischen Lernstunden und Punkten zeigt gemeinsame Veränderung, nicht, dass mehr Lernen die Punkte hebt; Vorwissen oder Motivation könnten beides erhöhen.

Der zweite Fehler: ein hohes r bei wenigen Paaren für gesichert zu halten. Bei 5 Paaren ergibt r = 0,7746 nur p = 0,1240, und das Intervall reicht von −0,3401 bis 0,9842, also bis in den negativen Bereich.

Der dritte Fehler: r = 0 als „kein Zusammenhang“ zu lesen. Pearson misst nur lineare Zusammenhänge: Zu x = −3 bis 3 und y = x² (9, 4, 1, 0, 1, 4, 9) gehört r = 0,0000 und p = 1,0000, obwohl y genau von x abhängt.

Der vierte Fehler: Pearson auf Rangdaten oder bei Ausreißern anzuwenden. Für x = 1 bis 8 und y = 1, 4, 9, … , 64 ist r = 0,9762, ρ aber 1,0000. Der fünfte Fehler: den einseitigen Test erst nach dem Blick auf die Daten zu wählen.

Bei den 5 Paaren halbiert er p von 0,1240 auf 0,0620, was nur gilt, wenn die Richtung vorher feststand.

Nächster Schritt

Korrelation berechnen: das Wichtigste in Kürze

Die Kernaussage für die direkte Weiterentscheidung.

Der Korrelation-Rechner liefert aus Datenpaaren Pearson r oder Spearman ρ, das Bestimmtheitsmaß, den p-Wert, ein Konfidenzintervall nach Fisher und die Regressionsgerade. Im Standardfall mit 8 Paaren sind es r = 0,9713 und p unter 0,0001.

Merke dir drei Punkte: Ein hohes r braucht bei wenigen Paaren einen kleinen p-Wert, Pearson erfasst nur Geraden und reagiert auf Ausreißer, und Korrelation ist keine Kausalität.

Grundlage sind die Formeln der Wikipedia-Fachartikel zu Pearson, Spearman und Effektstärken mit den Konventionen nach Cohen (1988), am 11.10.2026 gelesen; die t-Quantile stimmen mit den NIST-Tafeln überein.

Grenzen: Der p-Wert für Spearman ist eine t-Näherung, das Intervall gilt nur für Pearson, Kendalls τ fehlt. Als Nächstes berechnest du mit dem Lineare-Regression-Rechner Prognosen aus der Geraden.

Vertiefung

Rechenbeispiele: Pearson, Spearman, kleine Stichprobe und Ausreißer

Step-by-Step Walkthroughs. Realistische Szenarien.

Beispiel 1 · Einfach · r = 0,7746, r² = 0,6000, t = 2,1213 bei df = 3, p = 0,1240, Intervall −0,3401 bis 0,9842

Nur 5 Datenpaare

Welche Korrelation willst du berechnen?
Pearson (linearer Zusammenhang der Messwerte)
x-Werte (erste Messreihe)
1;2;3;4;5
y-Werte (zweite Messreihe)
2;4;5;4;5
Signifikanzniveau α
5 % (α = 0,05)

Weitere 1 Eingabewerte sind in dieser Beispielrechnung enthalten.

Beispiel 2 · Mittel · ρ = −0,1758, ρ² = 0,0309, t = −0,5050 bei df = 8, p = 0,6272

Spearman für IQ und Fernsehstunden

Welche Korrelation willst du berechnen?
Spearman (Rangkorrelation, auch bei Bindungen)
x-Werte (erste Messreihe)
86;97;99;100;101;103;106;110;112;113
y-Werte (zweite Messreihe)
0;20;28;27;50;29;7;17;6;12
Signifikanzniveau α
5 % (α = 0,05)

Weitere 1 Eingabewerte sind in dieser Beispielrechnung enthalten.

Beispiel 3 · Komplex · r = 0,7377, r² = 0,5443, p = 0,0367, Intervall 0,0689 bis 0,9490

Ein Ausreißer verzerrt Pearson

Welche Korrelation willst du berechnen?
Pearson (linearer Zusammenhang der Messwerte)
x-Werte (erste Messreihe)
1;2;3;4;5;6;7;8
y-Werte (zweite Messreihe)
1;2;3;4;5;6;7;30
Signifikanzniveau α
5 % (α = 0,05)

Weitere 1 Eingabewerte sind in dieser Beispielrechnung enthalten.

Beispiel 4 · Komplex · ρ = 0,9706, ρ² = 0,9420, t = 8,0632 bei df = 4, p = 0,0013

Spearman mit Rangbindungen

Welche Korrelation willst du berechnen?
Spearman (Rangkorrelation, auch bei Bindungen)
x-Werte (erste Messreihe)
3;5;5;8;9;12
y-Werte (zweite Messreihe)
2;6;4;7;9;9
Signifikanzniveau α
5 % (α = 0,05)

Weitere 1 Eingabewerte sind in dieser Beispielrechnung enthalten.

Weiterführende Rechner und Themen

Alle Anschlussrechner und Vertiefungen in einem klaren Modul, damit du direkt zur nächsten sinnvollen Berechnung springen kannst.

MedianrechnerMedian und Modus einer Wertegruppe berechnen – inklusive Sortierung und Einordnung.Z-Wert-RechnerZ-Score z = (x−μ)/σ und Percentilrang der Standardnormalverteilung berechnen.t-Test-Rechnert-Test berechnen: Einstichproben-, gepaarter und Zweistichproben-Test (Welch oder gleiche Varianzen) aus Kennzahlen oder Rohdaten – mit p-Wert, kritischem t-Wert, Entscheidung und t-Tabelle.Stichprobengröße-RechnerStichprobengröße berechnen für Umfragen (Anteil), Mittelwerte und den Vergleich zweier Gruppen (Poweranalyse) – mit Endlichkeitskorrektur, Rücklaufquote, Rechenweg und Tabelle nach Fehlermarge und Konfidenzniveau.Erwartungswert-RechnerErwartungswert E(X), Varianz Var(X) und Standardabweichung σ einer diskreten Wahrscheinlichkeitsverteilung aus einer Wertetabelle berechnen.PerzentilrechnerBeliebiges Perzentil sowie Quartile Q1, Median und Q3, Interquartilsabstand, Minimum und Maximum aus einer Zahlenliste berechnen.Kritischer-Wert-RechnerKritischen Wert und p-Wert für z, t, χ² und F berechnen: ein- oder zweiseitig, mit Ablehnungsbereich, Testentscheidung und t-Wert-Tabelle.Spannweite-RechnerSpannweite R = Maximum − Minimum aus einer Zahlenliste berechnen – mit Median, Mittelwert, Minimum, Maximum und sortierter Werteliste.Tschebyscheff-RechnerTschebyscheff-Ungleichung berechnen: Obergrenze für Abweichungen vom Erwartungswert, Mindestanteil im Intervall, k-Sigma-Form, ε-Form, Intervall und Binomialverteilung mit Vergleich zu Normalverteilung und exakter Wahrscheinlichkeit.Binomialverteilung-RechnerBinomialverteilung berechnen: P(X=k), P(X<=k), P(X>=k) fuer Bernoulli-Ketten mit Erwartungswert, Varianz und Standardabweichung.AQL-TabelleAQL-Stichprobenplan nach ISO 2859-1 berechnen: Losgröße und Prüfniveau eingeben, Kennbuchstabe, Stichprobenumfang, Annahmezahl und Rückweisezahl für Normal-, verschärfte und reduzierte Prüfung ermitteln.Gini-Koeffizient-RechnerGini-Koeffizient berechnen aus einer Werteliste oder aus klassierten Daten: Gini, normierter Gini, Gini-Index, Anteil der obersten 10 und 20 Prozent und Lorenzkurven-Tabelle mit Rechenweg.Häufigkeit-RechnerRelative Häufigkeit berechnen: aus einer Urliste oder aus h und n die Häufigkeitstabelle mit absoluter, relativer, prozentualer und kumulierter Häufigkeit, Modalwert und gekürztem Bruch, wahlweise mit Klassen.Odds-Ratio-RechnerOdds Ratio (Chancenverhältnis) aus der Vierfeldertafel berechnen: mit Konfidenzintervall nach Woolf, Haldane-Korrektur bei Nullzellen, relativem Risiko, Risikodifferenz und NNT.Benford-RechnerBenfordsches Gesetz prüfen: Zahlenliste einfügen und die führenden Ziffern mit der Sollverteilung vergleichen – mit χ²-Test, MAD, Tabelle je Ziffer und Hinweisen zu Listengröße und Aussagekraft.

Weiternutzung

Grafiken weiterverwenden

Alle 3 Grafiken dieser Seite darfst du in eigenen Artikeln und Beiträgen verwenden.

Nutzung frei, wenn du rechner-portal.de als Quelle verlinkst. CC BY 4.0

  • Streudiagramm von 8 Datenpaaren (Lernstunden und Klausurpunkte) mit Regressionsgerade: Pearson r = 0,9713, r² = 0,9435, p unter 0,0001, 95-Prozent-Intervall 0,8450 bis 0,9950.

    Streudiagramm: 8 Paare, r = 0,9713, Gerade y = 43,9956 + 3,6848 · x

    760 × 360 Pixel · Schaubild

    Herunterladen

    Einbettungscode

    HTML zum Einbinden

    <a href="https://rechner-portal.de/mathematik/statistik/korrelation-rechner">
      <img src="https://rechner-portal.de/images/mathematik/korrelation-rechner-streudiagramm.svg"
           alt="Streudiagramm von 8 Datenpaaren (Lernstunden und Klausurpunkte) mit Regressionsgerade: Pearson r = 0,9713, r² = 0,9435, p unter 0,0001, 95-Prozent-Intervall 0,8450 bis 0,9950."
           width="760" height="360">
    </a>
    <p>Quelle: <a href="https://rechner-portal.de/mathematik/statistik/korrelation-rechner">Streudiagramm: 8 Paare, r = 0,9713, Gerade y = 43,9956 + 3,6848 · x auf Rechner-Portal</a></p>

    Textbaustein für die Bildunterschrift

    Quelle: Rechner-Portal (rechner-portal.de) — https://rechner-portal.de/mathematik/statistik/korrelation-rechner
  • Ausreißer: bei x = 1 bis 8 und y = 1 bis 7 plus einem Wert 30 sinkt Pearson r auf 0,7377, während Spearman ρ bei 1,0000 bleibt; ohne den Ausreißer wäre r = 1,0000.

    Ausreißer: Pearson r = 0,7377, Spearman ρ = 1,0000 bei denselben Daten

    760 × 360 Pixel · Schaubild

    Herunterladen

    Einbettungscode

    HTML zum Einbinden

    <a href="https://rechner-portal.de/mathematik/statistik/korrelation-rechner">
      <img src="https://rechner-portal.de/images/mathematik/korrelation-rechner-ausreisser.svg"
           alt="Ausreißer: bei x = 1 bis 8 und y = 1 bis 7 plus einem Wert 30 sinkt Pearson r auf 0,7377, während Spearman ρ bei 1,0000 bleibt; ohne den Ausreißer wäre r = 1,0000."
           width="760" height="360">
    </a>
    <p>Quelle: <a href="https://rechner-portal.de/mathematik/statistik/korrelation-rechner">Ausreißer: Pearson r = 0,7377, Spearman ρ = 1,0000 bei denselben Daten auf Rechner-Portal</a></p>

    Textbaustein für die Bildunterschrift

    Quelle: Rechner-Portal (rechner-portal.de) — https://rechner-portal.de/mathematik/statistik/korrelation-rechner
  • Signifikanzschwelle nach Zahl der Paare: bei 5 Paaren ab |r| = 0,8783, bei 8 Paaren ab 0,7067, bei 20 Paaren ab 0,4438; beobachtet r = 0,7746, 0,9713 und 0,2883.

    Signifikanzschwelle: |r| ab 0,8783 bei 5, ab 0,7067 bei 8 und ab 0,4438 bei 20 Paaren

    760 × 360 Pixel · Schaubild

    Herunterladen

    Einbettungscode

    HTML zum Einbinden

    <a href="https://rechner-portal.de/mathematik/statistik/korrelation-rechner">
      <img src="https://rechner-portal.de/images/mathematik/korrelation-rechner-schwelle.svg"
           alt="Signifikanzschwelle nach Zahl der Paare: bei 5 Paaren ab |r| = 0,8783, bei 8 Paaren ab 0,7067, bei 20 Paaren ab 0,4438; beobachtet r = 0,7746, 0,9713 und 0,2883."
           width="760" height="360">
    </a>
    <p>Quelle: <a href="https://rechner-portal.de/mathematik/statistik/korrelation-rechner">Signifikanzschwelle: |r| ab 0,8783 bei 5, ab 0,7067 bei 8 und ab 0,4438 bei 20 Paaren auf Rechner-Portal</a></p>

    Textbaustein für die Bildunterschrift

    Quelle: Rechner-Portal (rechner-portal.de) — https://rechner-portal.de/mathematik/statistik/korrelation-rechner

Quellen, Transparenz und Haftung

Haftungsausschluss

Die Ergebnisse dieses Rechners sind Orientierungswerte und ersetzen keine professionelle Beratung. Für verbindliche Entscheidungen – insbesondere in finanziellen, gesundheitlichen oder rechtlichen Angelegenheiten – empfehlen wir die Einholung fachkundiger Beratung. Aktuelle Vertrags-, Produkt- und Regulierungsdaten können von den Rechenwerten abweichen.

Rechnerspezifische Grenzen: Der Rechner beschreibt den statistischen Zusammenhang der eingegebenen Daten. Er belegt keine Ursache und keinen Wirkungszusammenhang und prüft nicht, ob die Voraussetzungen von Test und Intervall (annähernd bivariate Normalverteilung, unabhängige Beobachtungen) erfüllt sind. Für Studien und Veröffentlichungen gilt die Auswertung in der Statistik-Software.

Quelle: Statistik: Pearson und Spearman nach Wikipedia-Fachartikeln mit Fisher-Transformation; kritische Werte numerisch aus der t-Verteilung; Stand Oktober 2026.

Stand: 2026-10-11

Externe Fachquellen
Qualitätsnachweise
Verantwortlich
Kilian Achatz
Herausgeber
Rechner-Portal
Letzte fachliche Prüfung
11. Oktober 2026
Fachbereich
Mathematik / Statistik
Formeln basieren auf
Pearson r = Sxy / √(Sxx · Syy); Spearman ρ = Pearson-r der Ränge (mittlere Ränge bei Bindungen); r² = r · r; t = r · √((n − 2) / (1 − r²)), df = n − 2; Konfidenzintervall tanh(artanh(r) ± z₁₋α/₂ / √(n − 3)); kritischer Betrag |r| = t / √(n − 2 + t²); Regression b = Sxy / Sxx, a = ȳ − b · x̄.
Zitation & Richtlinien

APA-Format

Rechner-Portal (2026). Korrelation-Rechner. Abgerufen von https://rechner-portal.de/mathematik/statistik/korrelation-rechner

Harvard-Format

Rechner-Portal, 2026. Korrelation-Rechner. Available at: https://rechner-portal.de/mathematik/statistik/korrelation-rechner

Werbestatus

Mögliche Werbung hat keinen Einfluss auf Rechenweg, Ergebnis oder Priorisierung dieses Rechners.