Rechenbasis
Annahmen und Grenzen
Was der Rechner voraussetzt und wo seine Aussage endet.
4 Annahmen und 3 Grenzen
Annahmen
- Jede Zeile ist ein Datenpaar (x | y); die Paare sind voneinander unabhängig erhoben und die x- und die y-Liste stehen in derselben Reihenfolge. Mindestens 3 Paare, höchstens 2.000.
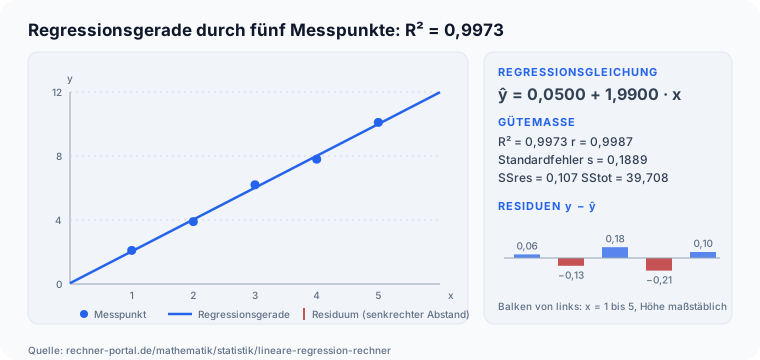
- Die Methode der kleinsten Quadrate minimiert die Summe der quadrierten senkrechten Abstände (Residuen) zwischen den y-Werten und der Kurve, nicht die Abstände zu beiden Achsen.
- Exponentiell und Potenz werden über den natürlichen Logarithmus linearisiert; dabei minimiert die Anpassung die Fehlerquadrate der ln-Werte. R², Standardfehler und Residuen stehen auf der ursprünglichen y-Skala, das R² der linearisierten Daten daneben.
- Die sprachliche Stärke-Einordnung des Korrelationskoeffizienten folgt Cohens Konventionen (1988): |r| ab 0,10 klein, ab 0,30 mittel, ab 0,50 groß. Das ist eine Konvention aus der Verhaltensforschung, kein Naturgesetz.
Grenzen
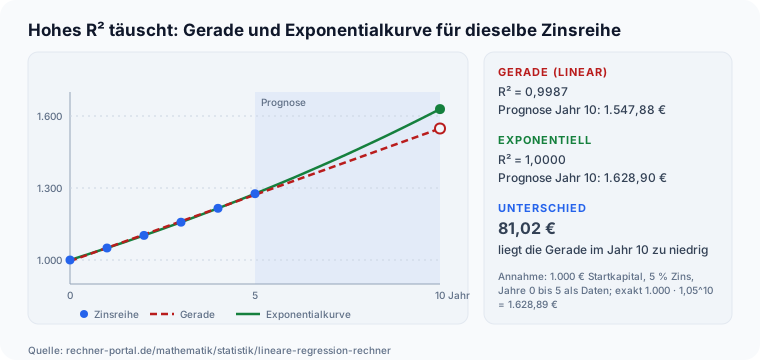
- Der Rechner prüft nicht, ob das gewählte Modell zu den Daten passt. Ein hohes R² schließt ein systematisches Muster in den Residuen nicht aus; die Residuentabelle gehört zur Beurteilung.
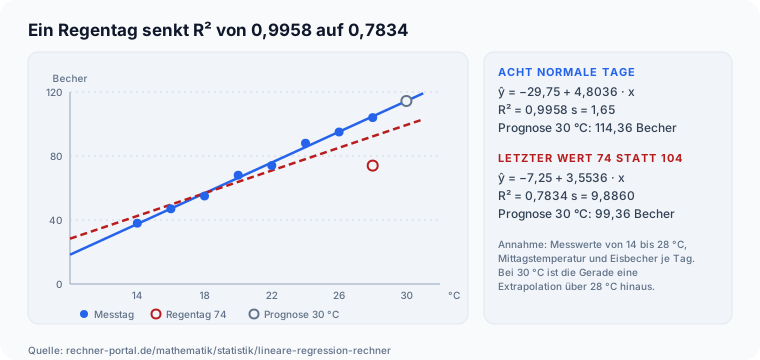
- Ein einzelner Ausreißer kann Gerade und R² stark verschieben, besonders bei wenigen Paaren. Korrelation belegt keine Ursache.
- Prognosen außerhalb des Bereichs der x-Werte sind Extrapolationen; Konfidenz- und Prognoseintervalle sowie Signifikanztests für die Koeffizienten berechnet der Rechner nicht.
Stand der Prüfung: Formeln zeitlos (Methode der kleinsten Quadrate); Quellen abgerufen am 09.10.2026.